Skip to content

投机解码 ​

论文: Fast Inference from Transformers via Speculative Decoding — ICML 2023

Speculative Decoding 用小模型串行生成草稿,再由大模型一次并行验证多个 Token。它以额外计算换取更低延迟,并通过拒绝采样保证输出分布与 Target Model 完全一致。

1. 执行流程 ​

设 Target Model 的分布为 p,Draft Model 的分布为 q,草稿窗口长度为 γ。一轮解码包含四步:

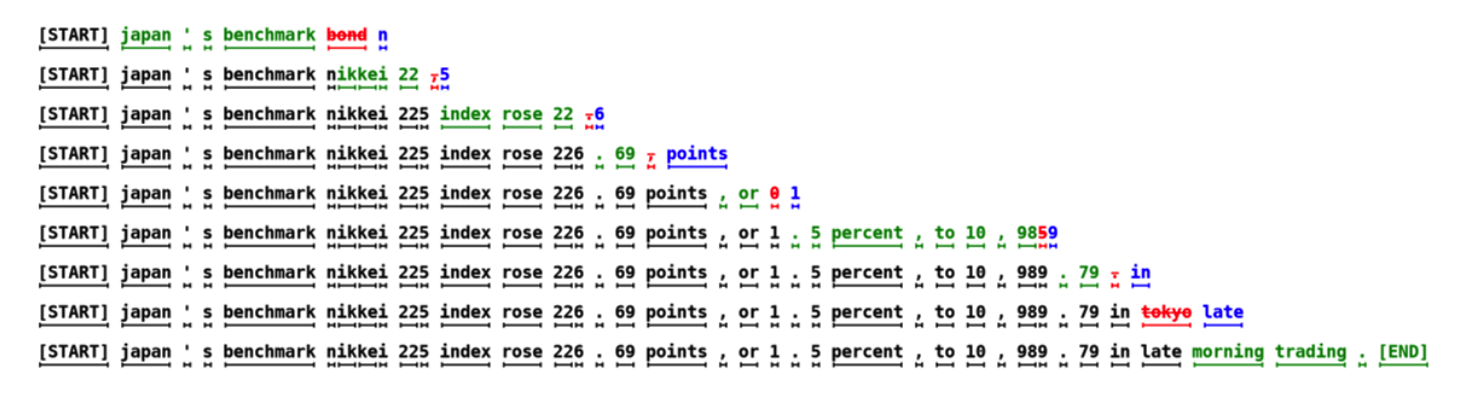
  1. Draft:小模型自回归采样 γ 个候选 Token,并保存各位置的 qi。
  2. Verify:大模型利用 Causal Mask,一次 Forward 得到 γ+1 个位置的分布 pi。
  3. Accept:从左到右验证候选;遇到第一个拒绝位置便停止。
  4. Resample:拒绝时从修正分布采样一个 Token;若全部接受,则从 pγ+1 额外采样一个 Token。

Speculative Decoding 的草稿、并行验证与接受过程

因此每轮至少产出 1 个 Token,最多产出 γ+1 个 Token:

text
Draft Model:  x₁ → x₂ → ... → xγ       串行生成草稿
Target Model:[x₁, x₂, ..., xγ]          一次并行验证
输出:         接受的前缀 + 1 个新采样 Token

加速来自 Target Model 的并行验证,而不是 Draft 阶段;Draft Model 必须足够快,候选也必须足够准。

2. 分布等价性 ​

把 Target Model 的分布 p 看作最终必须得到的概率配额,Draft Model 的分布 q 只负责提出候选。对候选 x,接受概率为:

A(x)=min(1,p(x)q(x))

候选 x 先被 Draft Model 采到,再通过验证的概率为:

q(x)A(x)=min(q(x),p(x))

这一步只保留 p 与 q 重叠的概率质量:若 Draft 对 x 给得太多,接受概率会将其截断到 p(x);若 Draft 给得不足,缺少的部分留给拒绝后的修正采样。

整轮发生拒绝的概率为 Z。由于 p、q 的总概率都为 1,两侧不重叠的概率质量相等:

Z=∑xmax(0,q(x)−p(x))=∑xmax(0,p(x)−q(x))

拒绝后,只从 Target 尚缺少的概率质量中采样:

p′(x)=max(0,p(x)−q(x))Z

当 Z=0 时,p=q,所有候选都会被接受,不会使用 p′。

因此 x 的最终概率由“候选被接受”和“拒绝后被补回”两条路径组成:

条件接受路径修正路径最终概率
q(x)≤p(x)q(x)p(x)−q(x)p(x)
q(x)>p(x)p(x)0p(x)
P(x)=min(q(x),p(x))+max(0,p(x)−q(x))=p(x)

上式证明单个位置的输出服从 p。多 Token 验证从左到右执行,每个位置都基于同一个已接受前缀重复这项校正,因此整段输出与 Target Model 自回归采样的序列分布一致。贪心解码则直接接受与 Target Model 一致的最长草稿前缀。

3. 加速条件 ​

令 α 为平均接受率。若各草稿位置的条件接受率近似相同,一轮期望产出为:

E[N]=1+α+α2+⋯+αγ=1−αγ+11−α

再令 Target Model 单步耗时为 T,Draft Model 单步耗时为 cT,忽略其他调度开销,则近似加速比为:

Speedup=1−αγ+1(1−α)(1+γc)

性能由三个因素共同决定:

  • 接受率 α:Draft 越接近 Target,每轮接受的 Token 越多。
  • 相对成本 c:Draft 越轻,投机开销越低。
  • 窗口 γ:窗口过短浪费并行能力,过长则增加无效 Draft 与验证计算。

当 γ=1 时,α>c 即可加速;更长窗口仍需结合实际调度、Batch Size、KV Cache 和硬件测试。论文在 T5-XXL 等模型上报告约 2–3× 延迟改善,但该结果不能直接外推到其他 Serving 配置。

4. 参考 ​

  1. Fast Inference from Transformers via Speculative Decoding
  2. Google Research:Looking Back at Speculative Decoding