Radix Attention
RadixAttention 是 SGLang 提出的自动前缀缓存机制:它用 Radix Tree(压缩前缀树)索引 Token 序列及其 KV Cache,让具有相同前缀的请求直接复用已有 KV。它没有修改 Attention 公式,优化的是 Prefill 阶段的重复计算与 KV 存储。
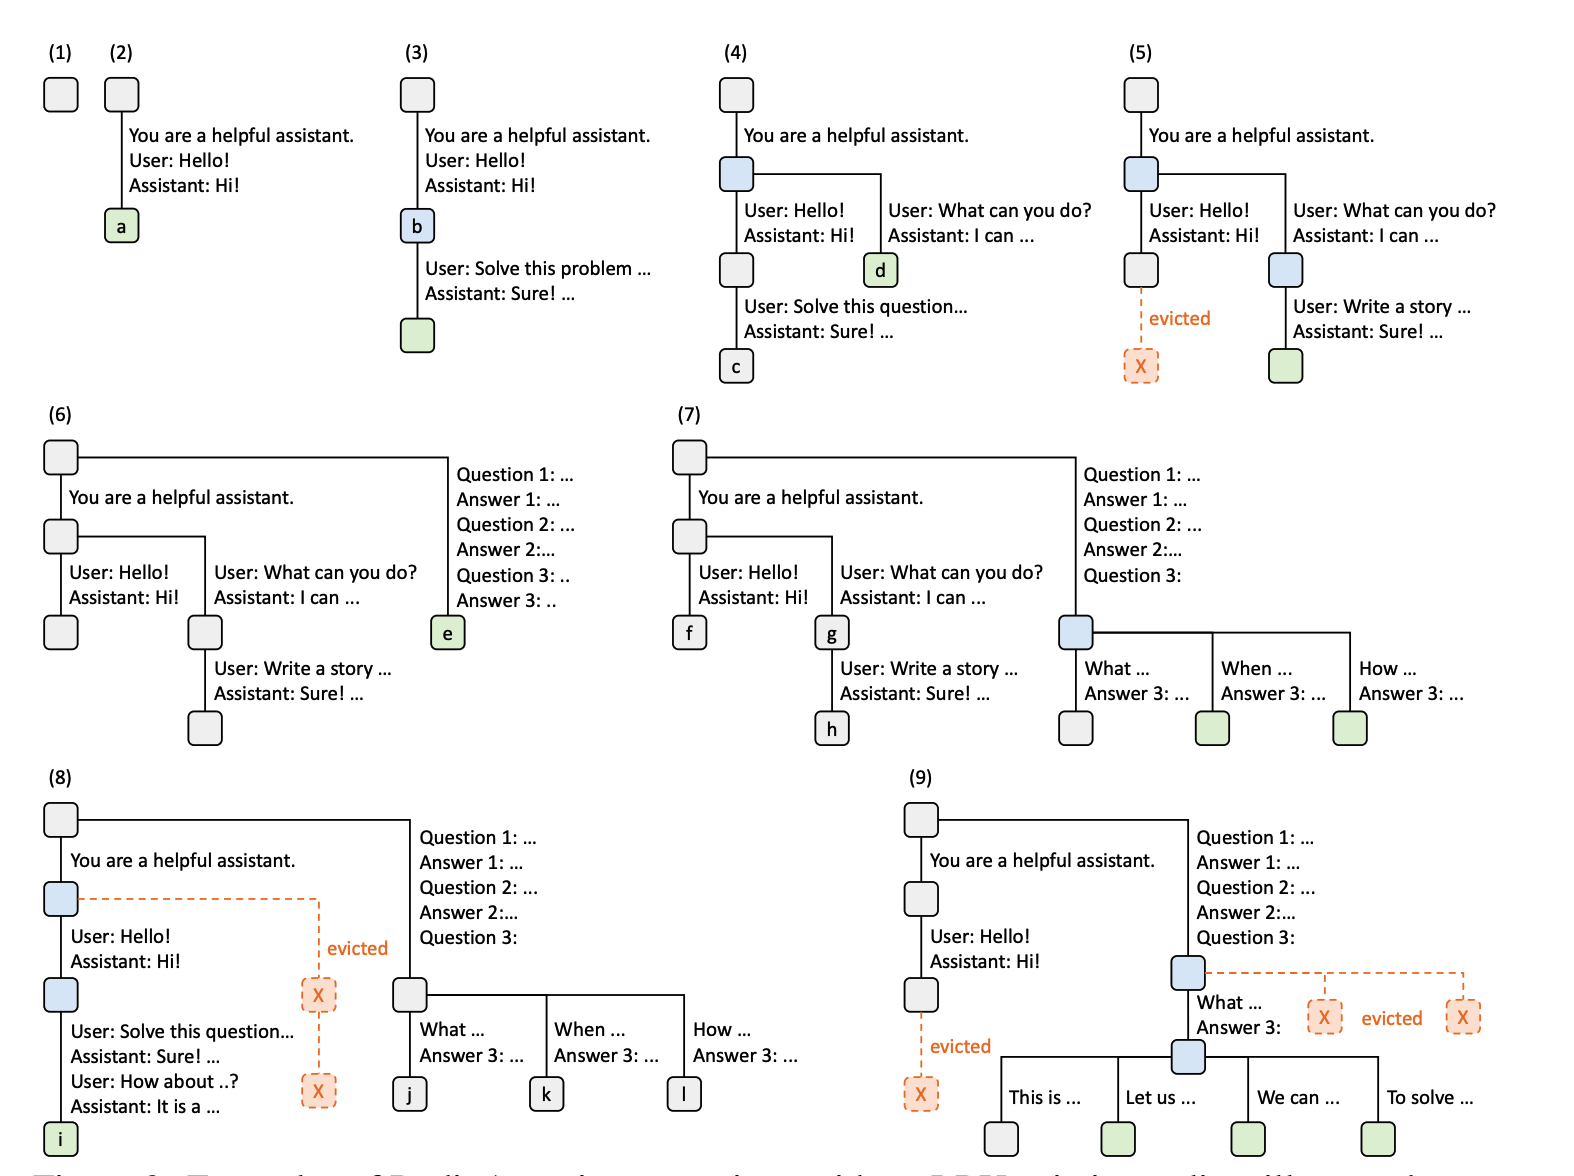
上图按时间顺序展示 Radix Tree 的动态演化。边上的文本代表一段连续 Token;绿色节点是本轮新增节点,蓝色节点是本轮命中的缓存节点,橙色虚线节点是因显存不足而被淘汰的节点。a 到 l 是便于跨步骤追踪的节点标记,不是 Token 内容。
为什么需要前缀复用
在线请求经常共享大量前缀,例如相同的 System Prompt、Few-shot 示例、多轮对话历史或 RAG 模板。若每个请求都重新 Prefill,共享部分会被重复计算并保存多份 KV Cache。
RadixAttention 将相同前缀只保存一次。请求 B 到达时,调度器先找到最长缓存前缀,只计算 Question B 对应的后缀。
图中的核心数据结构
Radix Tree 的边保存一段连续 Token,而不是单个 Token;节点关联这段 Token 对应的 KV Cache 位置。公共前缀形成共享路径,不同后缀在分叉点产生子节点:
设请求 Token 序列为
推理时直接取得前
九个时刻如何演化
(1)空树
服务刚启动,Radix Tree 只有根节点,没有任何可复用的 Token 或 KV Cache。
(2)插入第一轮对话
首个请求包含 System Prompt、User: Hello! 和模型生成的 Assistant: Hi!。请求完成后,整段 Token 及其 KV Cache 被压缩成一条边写入树中,叶节点标记为 a。
You are a helpful assistant.
User: Hello!
Assistant: Hi!
(3)复用对话历史
同一会话继续提问。运行时对完整 Prompt 做最长前缀匹配,命中第一轮对话对应的节点 b,直接复用其 KV Cache;只计算 User: Solve this problem ... 之后的新 Token,并把新一轮对话追加为绿色叶节点。
(4)公共边发生分裂
第二个会话使用相同的 System Prompt,但第一轮用户消息不同。原本包含整段对话的边在 System Prompt 末尾被拆分:
                         ┌─ User: Hello! ... → c
System Prompt(共享) ────┤
                         └─ User: What can you do? ... → d
两个会话只保存一份 System Prompt KV;会话专属内容分别落在 c 和 d 分支。边的分裂只重组 CPU 上的树索引,不会重新计算已经存在的 KV。
(5)继续第二个会话并触发淘汰
第二个会话继续请求 User: Write a story ...,运行时命中 System Prompt 和节点 d,只计算新增一轮。由于 KV Cache 空间不足,较久未使用的第一会话叶节点 c 按 LRU 策略被淘汰;共享 System Prompt 仍被当前路径引用,因此继续保留。
(6)插入无公共前缀的 Few-shot 请求
新的 Few-shot Prompt 以 Question 1 开始,与聊天分支没有公共 Token 前缀,因此从根节点建立另一条独立分支,并把完整 Prompt 与输出缓存到节点 e。此时同一棵树同时管理 Chat 与 Few-shot 两类请求。
(7)拆分 Few-shot 公共示例
随后到达一批 Few-shot 请求。它们共享 Question 1 到 Question 3 之前的示例,只在最后一个问题的 What、When、How 等后缀上不同。运行时拆分节点 e,把公共示例提升为蓝色共享节点,再为每个问题建立独立分支。
这一步说明 RadixAttention 不只复用固定 System Prompt,也能自动发现批量请求中的多层公共前缀。
(8)重新访问第一会话
第一会话再次到达,并在原对话后追加 User: How about ...?。其路径被标为蓝色,新增回答写入节点 i。为释放空间,第二会话中最久未使用的 g、h 分支被淘汰;Few-shot 分支 j、k、l 暂时保留。
(9)Self-consistency 形成多分支
运行时收到对节点 j 对应问题进行多次采样的请求。所有采样共享到 j 为止的 Prompt KV,只为 This is ...、Let us ...、We can ...、To solve ... 等不同生成结果建立分支。为容纳这些新结果,LRU 淘汰节点 i、k、l。
这一步体现了生成结果同样可以作为后续请求的可复用前缀;RadixAttention 缓存的不只是输入 Prompt,也包括已经生成的 Token。
从图中抽象出的请求生命周期
- 匹配:Tokenize 后在树中查找最长公共前缀,取得可复用的 KV 索引。
- 锁定:请求运行期间增加路径引用,防止仍在使用的 KV 被淘汰。
- 扩展:只为未命中的后缀分配 KV,并在分叉处拆分或增加节点。
- 缓存:未完成请求的中间结果或完成请求的 Token 序列被插入树中。
- 淘汰:显存不足时,从未被引用的叶节点开始按 LRU 等策略释放 KV 页面。
匹配依据是精确的 Token 前缀,不是文本语义相似度。实际实现还需要隔离不同模型版本、LoRA Adapter 或显式 Cache Salt,避免错误共享状态。
优势与限制
| 方面 | 影响 |
|---|---|
| Prefill 计算 | 命中前缀无需重新经过 Transformer |
| TTFT | 高命中率场景下通常更低 |
| KV 显存 | 多个请求可以共享一份前缀 KV |
| 低复用流量 | 前缀很少重复时收益有限 |
| 缓存容量 | 保留旧前缀会占用本可服务新请求的 KV 空间 |
| 调度策略 | Cache-aware 调度可提高命中率,但还需兼顾公平性 |
RadixAttention 特别适合固定 System Prompt、Few-shot、RAG 模板和多轮对话;对于首个 Token 就不同的随机请求,它基本退化为普通 KV Cache 管理。
SGLang 中的实现
SGLang 的 RadixKey 由 Token ID 和可选 extra_key 构成;match_prefix 查找最长的页对齐前缀,insert 在需要时拆分节点并保存 KV 索引。请求持有的路径通过 lock_ref 保护,显存紧张时只淘汰未锁定的叶节点。
相关入口: