Qwen3.5
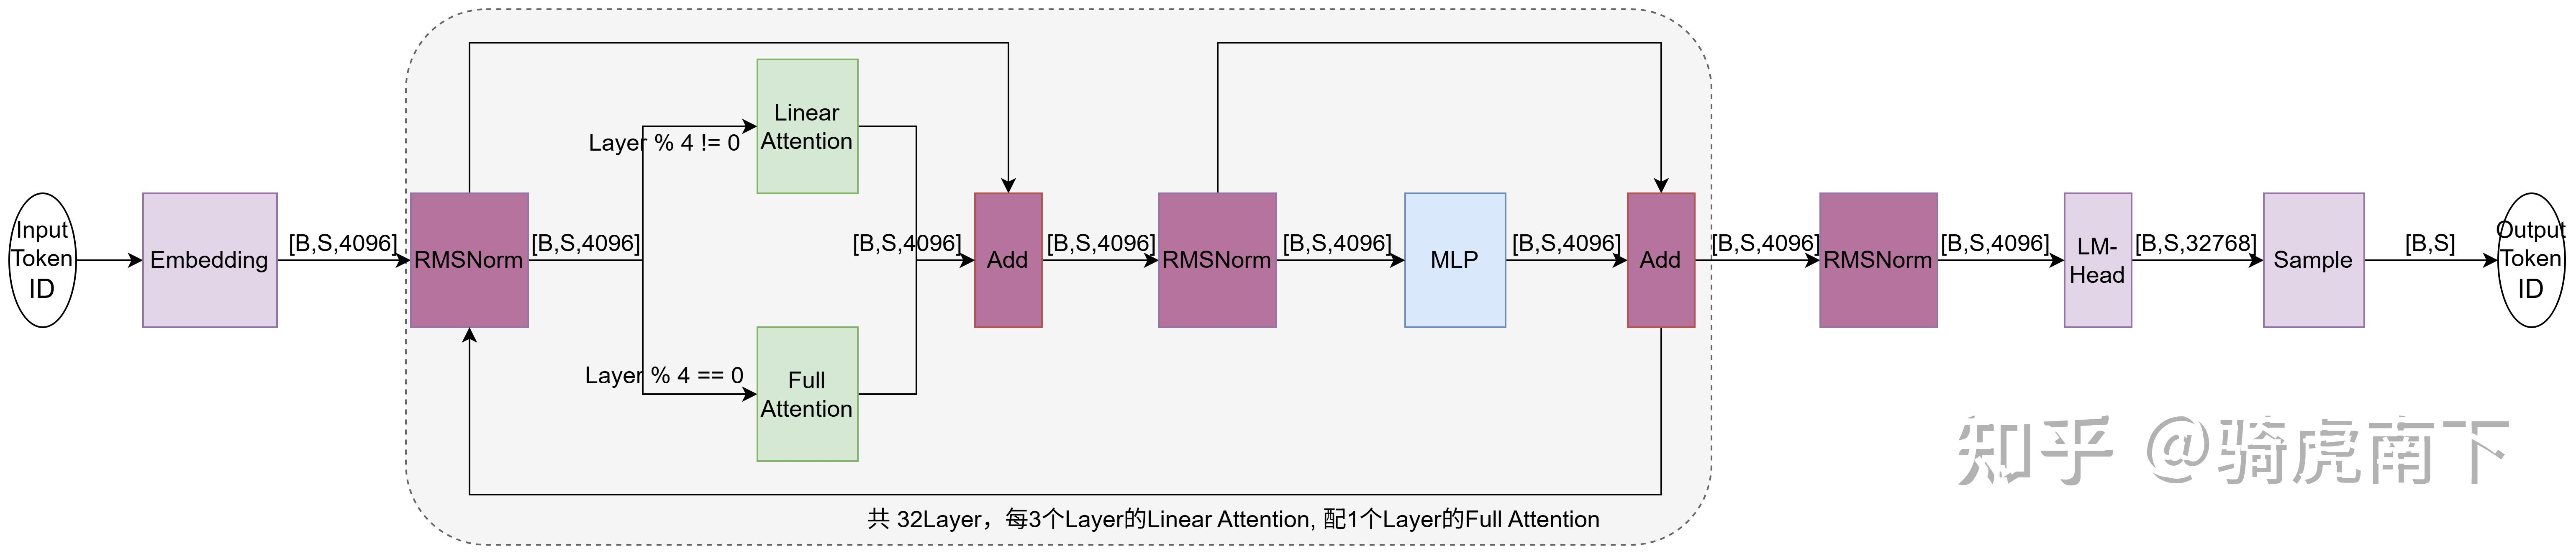
Qwen3.5 的核心创新是 混合注意力架构(Hybrid Attention),将 Full Attention 和 Linear Attention(Gated Delta Net)按固定比例交替使用,在保持模型能力的同时大幅降低推理时的内存和计算开销。
下文张量形状中,B = Batch Size(批大小),S = Sequence Length(序列长度)。
混合策略:每 4 层中 1 层使用 Full Attention(layer_idx % 4 == 0),其余 3 层使用 Linear Attention(GDN)。即 32 层中有 8 层 Full Attention + 24 层 GDN。
Full Attention
Full Attention 层采用 GQA + QK-Norm + Output Gating 的设计: 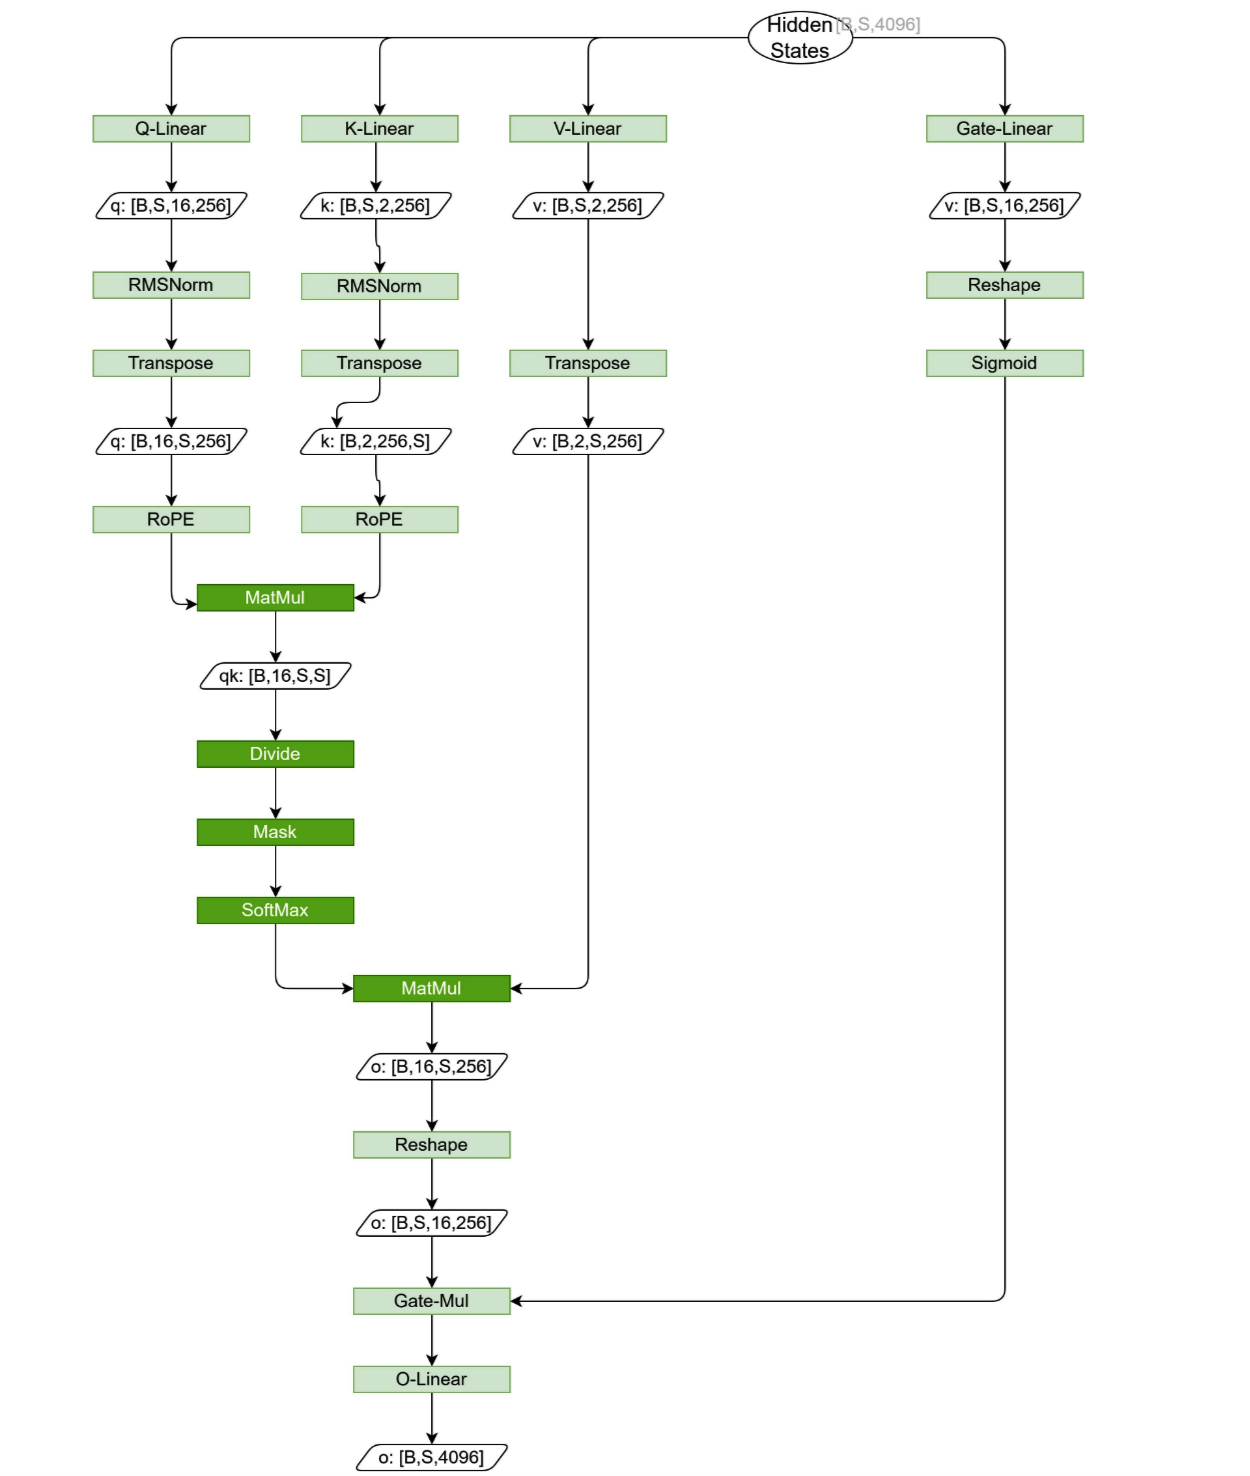
Output Gating
Output Gating思路与 SwiGLU MLP 中的门控类似,用一条额外的路径来控制主路径的信息流通:
Hidden States ─┬─→ Q/K/V-Linear ──→ Attention ──→ attn_output [B,S,16,256]
               │                                        │
               └─→ Gate-Linear ──→ Reshape ──→ Sigmoid ─┤
                    [B,S,16,256]    [B,S,16,256]  (0~1) │
                                                        ↓
                                                   逐元素相乘 ──→ O-Linear ──→ [B,S,4096]
📄 transformers/.../modeling_qwen3_5.py#L645-L717
class Qwen3_5Attention(nn.Module):
    def __init__(self, config, layer_idx):
        ...
        # Q 投影输出维度翻倍:前半是 query,后半是 gate
        self.q_proj = nn.Linear(config.hidden_size, config.num_attention_heads * self.head_dim * 2, bias=config.attention_bias)
        self.k_proj = nn.Linear(config.hidden_size, config.num_key_value_heads * self.head_dim, bias=config.attention_bias)
        self.v_proj = nn.Linear(config.hidden_size, config.num_key_value_heads * self.head_dim, bias=config.attention_bias)
        self.o_proj = nn.Linear(config.num_attention_heads * self.head_dim, config.hidden_size, bias=config.attention_bias)
        self.q_norm = Qwen3_5RMSNorm(self.head_dim, eps=config.rms_norm_eps)
        self.k_norm = Qwen3_5RMSNorm(self.head_dim, eps=config.rms_norm_eps)

    def forward(self, hidden_states, position_embeddings, attention_mask, past_key_values, ...):
        # Q 投影后拆分为 query 和 gate
        query_states, gate = torch.chunk(
            self.q_proj(hidden_states).view(*input_shape, -1, self.head_dim * 2), 2, dim=-1
        )
        gate = gate.reshape(*input_shape, -1)

        query_states = self.q_norm(query_states.view(hidden_shape)).transpose(1, 2)
        key_states = self.k_norm(self.k_proj(hidden_states).view(hidden_shape)).transpose(1, 2)
        value_states = self.v_proj(hidden_states).view(hidden_shape).transpose(1, 2)

        cos, sin = position_embeddings
        query_states, key_states = apply_rotary_pos_emb(query_states, key_states, cos, sin)

        attn_output, attn_weights = eager_attention_forward(
            self, query_states, key_states, value_states, attention_mask, ...
        )
        attn_output = attn_output.reshape(*input_shape, -1).contiguous()
        attn_output = attn_output * torch.sigmoid(gate)  # Output Gating
        attn_output = self.o_proj(attn_output)
return attn_output, attn_weights原理:Gating 的 shape 与 attention 输出维度一致 ,Sigmoid 将每个值压缩到
目的:在 Qwen3.5 的混合架构中,Full Attention 层只占 1/4,Gating 根据输入动态调节注意力输出的强度,相当于给 Full Attention 层更强的表达能力来弥补层数的减少;
Gated Delta Net(GDN)
GDN演进
- Linear Attention(Katharopoulos et al., 2020): 将 Softmax Attention 线性化为 RNN 式递推:
只有加法累积,旧信息无法修正——即使某个 token 的 value 已经过时,它的影响会永远留在
- Delta Net(Schlag et al., 2021):引入 delta rule——写之前先读旧值、只写差值:
- Gated Delta Net(Yang et al., 2024, ICLR 2025):在 Delta Net 基础上加入数据驱动的遗忘门
:
GDN详解
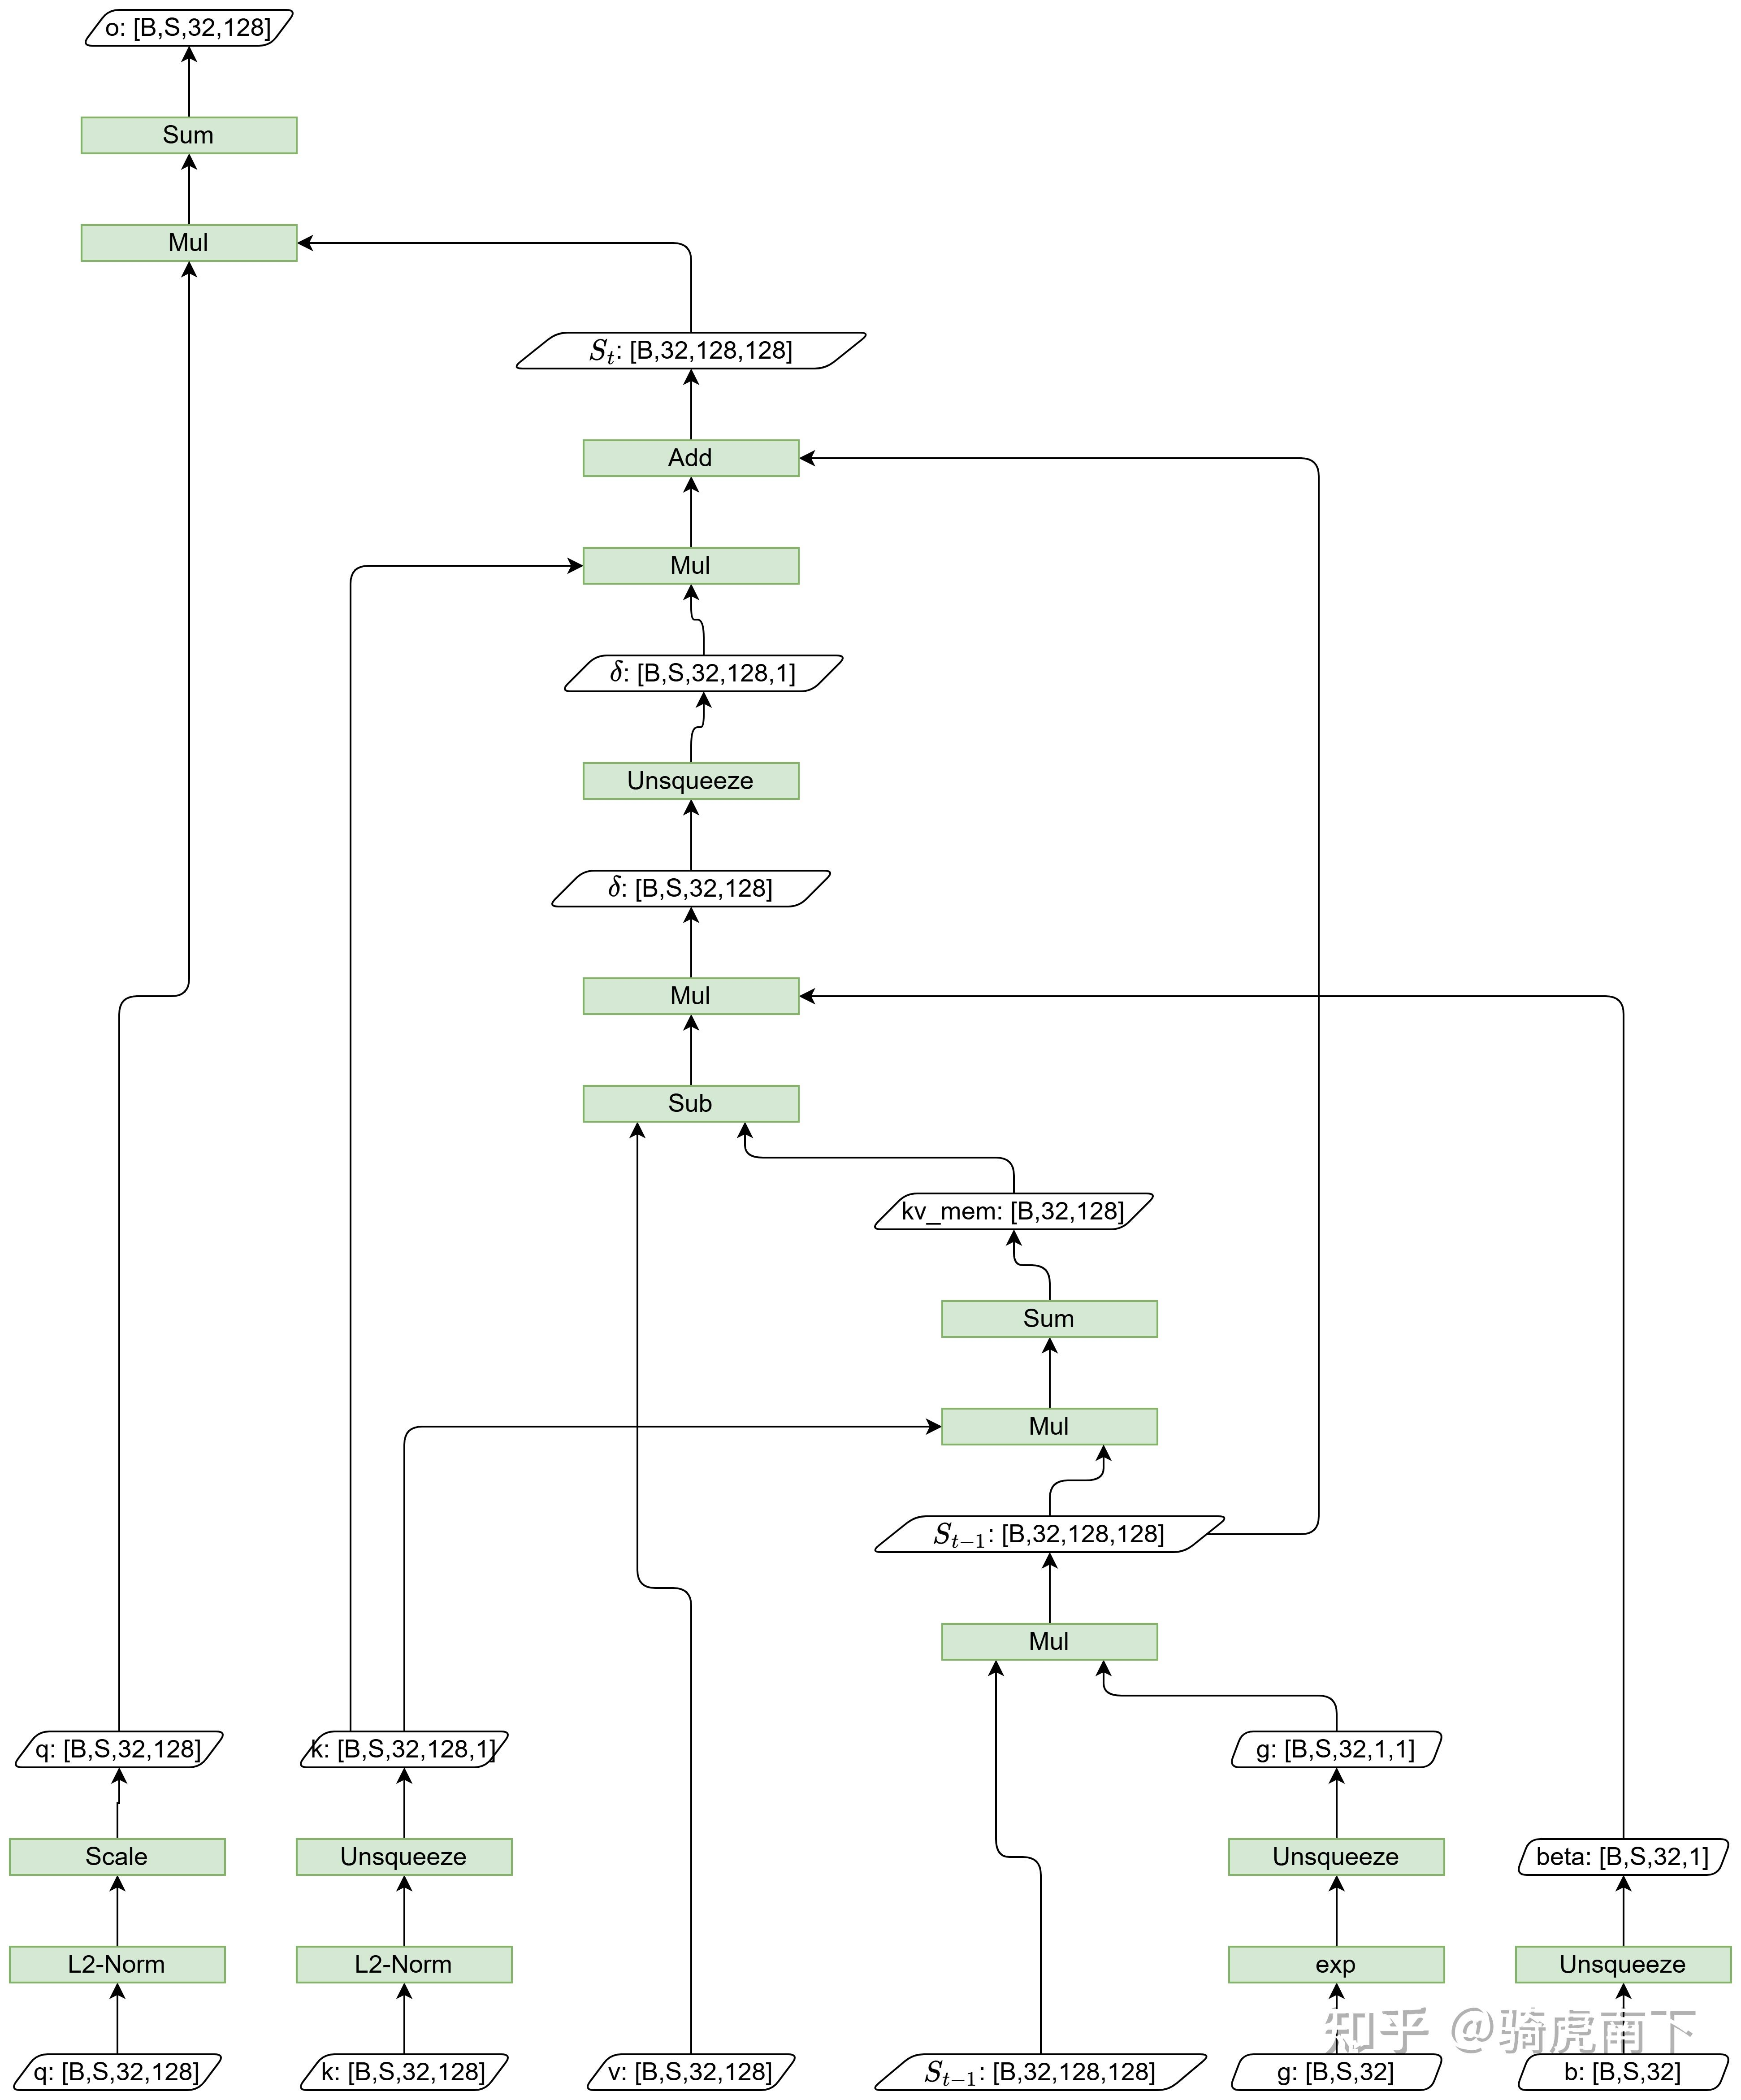
整体公式:
展开为五步递推:
📄 transformers/.../modeling_qwen3_5.py#L327-L368 — 递推核心
def torch_recurrent_gated_delta_rule(query, key, value, g, beta, initial_state, ...):
    ...
    for i in range(sequence_length):
        q_t = query[:, :, i]
        k_t = key[:, :, i]
        v_t = value[:, :, i]
        g_t = g[:, :, i].exp().unsqueeze(-1).unsqueeze(-1)  # α:衰减门
        beta_t = beta[:, :, i].unsqueeze(-1)                # β:写入强度

        last_recurrent_state = last_recurrent_state * g_t                              # 1. 衰减旧状态
        kv_mem = (last_recurrent_state * k_t.unsqueeze(-1)).sum(dim=-2)                # 2. 用 k 读:该地址已有什么
        delta = (v_t - kv_mem) * beta_t                                                # 3. 算差值
        last_recurrent_state = last_recurrent_state + k_t.unsqueeze(-1) * delta.unsqueeze(-2)  # 4. 写入差值
        core_attn_out[:, :, i] = (last_recurrent_state * q_t.unsqueeze(-1)).sum(dim=-2)        # 5. 用 q 读:提取输出
📄 transformers/.../modeling_qwen3_5.py#L371-L559 — 模块结构
class Qwen3_5GatedDeltaNet(nn.Module):
    def __init__(self, config, layer_idx):
        ...
        self.in_proj_qkv = nn.Linear(self.hidden_size, self.key_dim * 2 + self.value_dim, bias=False)  # Q/K/V
        self.in_proj_z = nn.Linear(self.hidden_size, self.value_dim, bias=False)    # output gate
        self.in_proj_b = nn.Linear(self.hidden_size, self.num_v_heads, bias=False)  # β 写入强度
        self.in_proj_a = nn.Linear(self.hidden_size, self.num_v_heads, bias=False)  # α 衰减门
        self.conv1d = nn.Conv1d(...)  # 局部特征提取
        self.norm = Qwen3_5RMSNormGated(...)
        self.out_proj = nn.Linear(self.value_dim, self.hidden_size, bias=False)

    def forward(self, hidden_states, cache_params, attention_mask, ...):
        mixed_qkv = self.in_proj_qkv(hidden_states)  # Q/K/V 投影
        z = self.in_proj_z(hidden_states)              # output gate
        b = self.in_proj_b(hidden_states)              # β
        a = self.in_proj_a(hidden_states)              # α 原始值

        # Conv1d → split Q/K/V → reshape
        query, key, value = torch.split(mixed_qkv, [...], dim=-1)
        beta = b.sigmoid()                                          # β ∈ (0, 1)
        g = -self.A_log.float().exp() * F.softplus(a.float() + self.dt_bias)  # α 衰减因子

        # 递推计算
        core_attn_out, last_state = self.recurrent_gated_delta_rule(
            query, key, value, g=g, beta=beta, ...
        )
        core_attn_out = self.norm(core_attn_out, z)  # RMSNorm + output gate
        output = self.out_proj(core_attn_out)
        return output