Qwen3
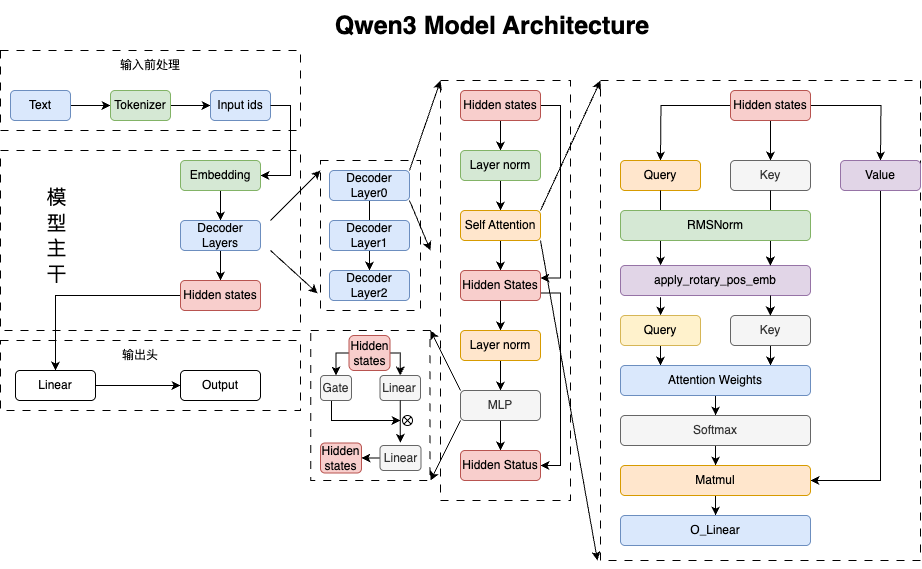
Qwen3 在 Qwen2 基础上引入了 QK-Norm,这是架构层面唯一的变化,其余结构(SwiGLU MLP、RoPE、GQA、Pre-Norm 残差连接、Weight Tying)与 Qwen2 完全一致。
transformers 中
Qwen3MLP与Qwen2MLP结构完全一致(SwiGLU),仅增加了intermediate_size参数
QK-Norm
在 Q、K 投影之后、施加 RoPE 之前,分别对 Q 和 K 按 head 维度做 RMSNorm 归一化:
为什么加 QK-Norm:
- Q、K 向量的范数随训练增长,导致 attention logits
的绝对值越来越大 - 极端的 logits 经过 Softmax 后接近 one-hot 分布,注意力退化为只关注单个 token
- 对 Q、K 做 RMSNorm 将范数约束在稳定范围内,防止 attention score 爆炸,提升长序列和大规模训练的稳定性
与 Qwen2 Attention 的对比:
Qwen2:  qkv_proj → split Q,K,V → RoPE(Q,K)           → Attention → o_proj
Qwen3:  qkv_proj → split Q,K,V → RMSNorm(Q,K) → RoPE → Attention → o_proj
                                  ^^^^^^^^^^^^
📄 transformers/.../modeling_qwen3.py#L222-L291
python
class Qwen3Attention(nn.Module):
    def __init__(self, config: Qwen3Config, layer_idx: int):
        ...
        self.q_proj = nn.Linear(config.hidden_size, config.num_attention_heads * self.head_dim, bias=config.attention_bias)
        self.k_proj = nn.Linear(config.hidden_size, config.num_key_value_heads * self.head_dim, bias=config.attention_bias)
        self.v_proj = nn.Linear(config.hidden_size, config.num_key_value_heads * self.head_dim, bias=config.attention_bias)
        self.o_proj = nn.Linear(config.num_attention_heads * self.head_dim, config.hidden_size, bias=config.attention_bias)
        self.q_norm = Qwen3RMSNorm(self.head_dim, eps=config.rms_norm_eps)
        self.k_norm = Qwen3RMSNorm(self.head_dim, eps=config.rms_norm_eps)

    def forward(self, hidden_states, position_embeddings, attention_mask, past_key_values, ...):
        input_shape = hidden_states.shape[:-1]
        hidden_shape = (*input_shape, -1, self.head_dim)

        # QK-Norm:投影后、RoPE 前做 RMSNorm
        query_states = self.q_norm(self.q_proj(hidden_states).view(hidden_shape)).transpose(1, 2)
        key_states = self.k_norm(self.k_proj(hidden_states).view(hidden_shape)).transpose(1, 2)
        value_states = self.v_proj(hidden_states).view(hidden_shape).transpose(1, 2)

        cos, sin = position_embeddings
        query_states, key_states = apply_rotary_pos_emb(query_states, key_states, cos, sin)

        if past_key_values is not None:
            key_states, value_states = past_key_values.update(key_states, value_states, self.layer_idx)

        attn_output, attn_weights = eager_attention_forward(
            self, query_states, key_states, value_states, attention_mask, ...
        )
        attn_output = attn_output.reshape(*input_shape, -1).contiguous()
        attn_output = self.o_proj(attn_output)
        return attn_output, attn_weights