Overlap Schedule
Overlap Schedule 将 CPU 调度与 GPU 计算组织成流水线:GPU 执行当前轮 Decode 时,CPU 处理上一轮结果并准备下一轮 Batch。SGLang 将这一机制称为 Zero-Overhead Batch Scheduler,通过提前调度、GPU 上的 token 接力和延后结果处理,减少相邻 Decode 之间的 GPU 空闲。
本文以普通自回归 Decode 为主,源码基于 SGLang 提交 0b3bb0cbe3。图中的轮次表示一次 Batch 执行,同一请求在相邻轮次之间仍然存在 token 依赖。
1. Decode 调度开销
一次 Decode 除了 GPU 上的 Forward 与 Sampling,还需要 CPU 接收请求、调整 Batch、分配 KV Cache、准备执行元数据,以及处理输出和停止条件。Prefix Cache 的匹配和维护也会占用调度时间。
普通调度先消费当前轮结果,再准备下一轮:
CPU:准备 Batch n
       ↓
GPU:Forward n → Sampling n
       ↓
CPU:等待结果拷回 → 处理结果 n → 准备 Batch n+1
       ↓
GPU:Forward n+1 → Sampling n+1
即使 CUDA Kernel 是异步提交的,只要 CPU 在提交下一轮之前等待当前轮结果,调度工作仍会落在 GPU 执行的关键路径上。单轮 GPU 时间越短,这部分空隙的占比越高。
2. CPU–GPU 流水线
2.1 提前调度
SGLang 的 Overlap Scheduler 先提交当前轮 GPU 工作,再处理上一轮结果。稳态下,CPU 的结果处理和下一轮准备可以被当前轮 GPU 计算覆盖。
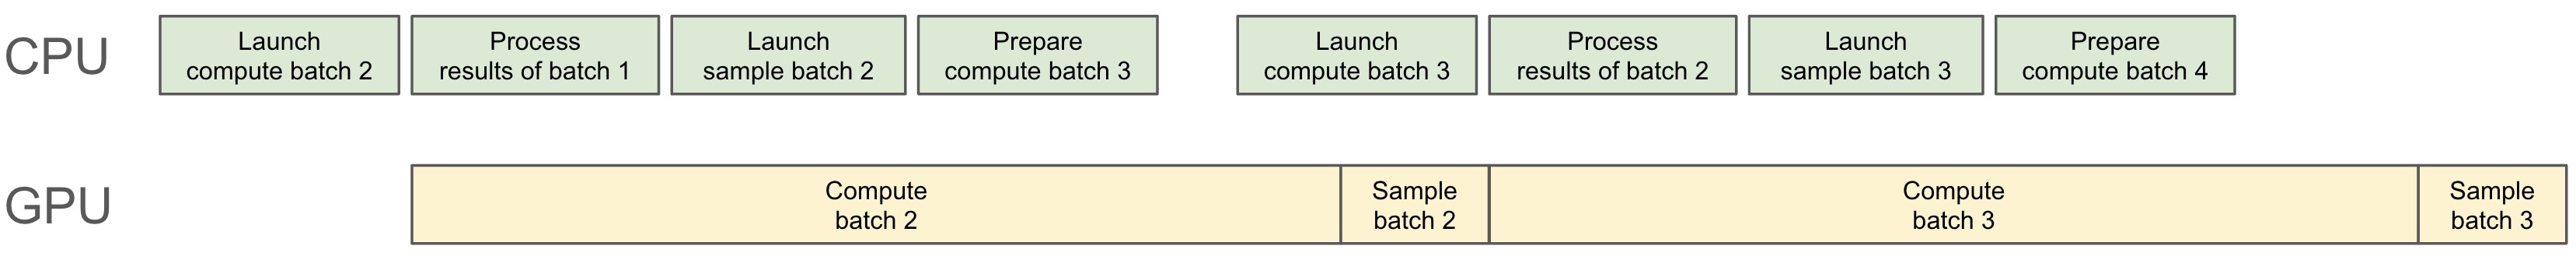
图 1:SGLang v0.4 官方调度时序图,点击可查看大图。来源:SGLang v0.4 发布说明。
图中的 CPU Launch 表示提交操作,不表示 GPU 已经执行完成。以 Batch 2 为例,CPU 依次提交 Forward 2、处理结果 1、提交 Sampling 2,然后准备 Batch 3;GPU 则按数据依赖执行 Forward 2、Sampling 2 和 Forward 3。
图中把 Forward 和 Sampling 分开,是为了表达采样可能依赖上一轮结果处理后的状态,例如语法约束。本文所分析的源码也保留了延迟采样分支;不需要延迟时,采样可以在 run_batch() 内提交。
2.2 元数据与 token 依赖
普通 Decode 每个请求只处理一个新位置。即使当前轮 token 尚未生成,CPU 仍可以提前确定请求的池索引、下一轮序列长度和需要分配的 KV 位置。
| 数据或操作 | 对当前轮真实 token 的依赖 | 处理位置 |
|---|---|---|
| 请求索引、候选 Batch | 无需知道 token 值,但结束状态可能滞后一轮 | CPU 提前准备 |
| 序列长度增加 1、分配新 KV 位置 | 普通 Decode 下无需知道 token 值 | 调度阶段准备 |
下一轮 input_ids | 必须取得当前轮采样结果 | GPU 在 Forward 入口解析 |
| EOS、停止字符串、输出内容 | 需要真实结果 | CPU 延后处理 |
| 语法状态与下一轮采样掩码 | 可能需要上一轮真实 token | 在采样前满足依赖 |
因此,提前调度不要求提前知道所有结果。它只要求将依赖真实 token 的操作推迟到实际消费该 token 的位置。
2.3 FutureMap 接力
SGLang 用 GPU 上的 FutureMap.output_tokens_buf 保存上一轮采样结果,并以请求池索引 req_pool_indices 定位。下一轮 Forward 开始前,再按当前 Batch 的请求顺序读取这些 token。
图 2:根据本文分析的 SGLang 源码绘制。请求池索引和 token ID 均为示例;图中交换请求顺序用于说明索引语义,不表示每轮都会重排。
设请求 A、B 的池索引为 [4, 9],第 [314, 271]。GPU 将它们写入槽位 4 和 9。若下一轮 Batch 顺序是 [B, A],只需按索引 [9, 4] Gather,即可得到输入 [271, 314];CPU 不必先读取这两个 token 的值。
这里的 Future 表示尚未就绪的真实结果。自回归依赖依然是:
这些 GPU 操作在 Forward Stream 中按序执行。CPU 可以提前提交下一轮操作,但 GPU 必须在上轮 token 写入后才能读取并执行下一轮。
3. SGLang 实现
3.1 调度循环
event_loop_normal() 在 run_batch() 后立即处理同一 Batch 的结果。event_loop_overlap() 则维护结果队列,提交当前轮后再弹出上一轮结果。
下面是普通生成路径的调度伪代码,省略暂停、特殊同步和部分空闲处理:
result_queue = deque()
last_batch = None

while True:
    receive_and_process_requests()
    apply_shared_buffer_barrier()
    batch = get_next_batch_to_run()

    result = None
    if batch is not None:
        result = run_batch(batch)  # 异步提交 GPU 工作
        result_queue.append((batch.copy(), result))

    if last_batch is not None:
        old_batch, old_result = result_queue.popleft()
        process_batch_result(old_batch, old_result)

    launch_batch_sample_if_needed(result)
    last_batch = batch
首轮只有提交,没有上一轮结果可处理。后续轮次先提交再消费;当没有新 Batch 时,队列中最后一轮结果仍会被处理。这里的 result 可以包含尚未完成的异步计算或拷贝,不能把函数返回视为 GPU 完成。
实际循环还会在特定条件下先处理上一轮结果,再提交当前轮,从而暂时退出重叠。具体入口见 event_loop_overlap()。
3.2 GPU 输入解析
设 Batch 中有 req_pool_indices、next_token_ids 和 input_ids 的形状均为 [B],output_tokens_buf 的形状为 [R]。
run_batch() 将采样结果交给 _relay_forward_payload(),后者调用 FutureMap.stash() 写入 GPU buffer。普通 Overlap 路径随后把 batch.input_ids 设为 None,表示下一轮输入需要在 Forward 入口解析。
📄 SGLang:resolve_forward_inputs() 与 FutureMap.stash()
# resolve_forward_inputs:普通 Decode 的 GPU Gather 分支
...
elif batch.input_ids is None and future_map.spec_algo.is_none():
    batch.input_ids = future_map.output_tokens_buf[batch.req_pool_indices]
    ...

# FutureMap.stash:写入按请求池索引组织的 GPU buffer
def stash(self, future_indices, payload):
    ...
    indices = future_indices
    ...
    self.output_tokens_buf[indices] = payload.bonus_tokens.to(
        self.output_tokens_buf.dtype
    )
    ...
bonus_tokens 是接力载荷的字段名;在普通 Decode 路径中,它承载当前轮的 next_token_ids。这一实现也被非 Overlap 路径复用,因此仅看到 FutureMap 并不能判断调度是否重叠,还需要检查实际执行的事件循环。
3.3 Stream 与结果拷贝
本文源码中的 CUDA 普通生成路径主要涉及三个 Stream:
| Stream | 作用 | 关键顺序 |
|---|---|---|
schedule_stream | 承载调度阶段提交的 GPU 操作 | 改写共享 buffer 前,等待上轮读取完成 |
forward_stream | 输入解析、模型计算、采样和 token 接力 | 等待本轮调度操作就绪;相邻轮次按序执行 |
copy_stream | 将结果异步拷回 CPU | 等待对应 Forward 结果就绪 |
CPU 线程本身并不“运行在 CUDA Stream 上”。Stream 管理的是该线程提交的设备操作;wait_stream() 和 wait_event() 为设备工作建立顺序,通常不会让 CPU 线程原地等待 GPU 完成。
CUDA 普通路径在独立 copy_stream 上拷贝 token、按需返回的 logprob 等结果,并记录 copy_done。CPU 真正消费结果前调用 copy_done.synchronize(),这时才可能阻塞主机线程。由于下一轮已经提交,等待和结果处理仍可能被下一轮 GPU 计算覆盖。
结果拷贝没有被取消:它仍用于输出、停止判断和请求维护。优化消除的是“必须先把 token 拷回 CPU,才能准备下一轮输入”的串行依赖。HIP 和延迟采样分支的拷贝安排有所不同,不能把这条 CUDA 路径推广到所有后端。
4. 依赖与资源安全
4.1 Batch 快照与内存生命周期
CPU 提前准备下一轮时,上轮 GPU 可能仍在读取旧的 tensor。若原地更新序列长度,或提前释放 tensor,异步执行就可能读到错误数据。
SGLang 在 Overlap 路径中使用新的序列长度 tensor,例如 self.seq_lens = self.seq_lens + 1,并通过 Batch 快照和两轮引用保留延长相关 tensor 的生命周期。结果队列中的 batch.copy() 保存对应轮次的 Batch 结构;这些措施各自处理结构修改和设备存储生命周期,不能把浅拷贝视为完整的内存隔离。
对于确实复用的共享 buffer,_apply_war_barrier() 在下一轮调度写入前等待上轮读取完成的事件;没有可用事件时,回退为等待已有 Forward Stream 工作。这里的 WAR 是 Write After Read,即后续写入必须晚于先前读取。
4.2 请求结束与额外一步
CPU 处理第
提交 Decode n+1,暂时仍包含请求 A
    ↓
处理结果 n:发现 A 已结束,记录结束状态
    ↓
处理结果 n+1:跳过 A,不追加多算出的 token
process_batch_result_decode() 会跳过已结束或已撤回的请求,相关释放逻辑负责回收多分配的 KV。请求结束后的结果也不会被重复输出。提前调度的代价因此包括少量无效计算,以及更复杂的资源生命周期管理。
4.3 语法约束与推测解码
结构化输出的采样掩码可能依赖上一 token 更新后的语法状态。模型 Forward 可以先提交,而采样需要等上一轮结果处理完成后再提交;这正是 launch_batch_sample_if_needed() 所表达的依赖。
在本文源码版本中,Speculative Decode 与 Grammar 同时启用且还有待处理结果时,调度器会先同步处理上一轮。推测解码每轮接受的 token 数也不固定,不能直接套用普通 Decode 的“长度加 1”;其 FutureMap 还涉及接受后的序列长度和 Draft 状态接力。
连续 Prefill 还存在另一种取舍:环境变量 SGLANG_DISABLE_CONSECUTIVE_PREFILL_OVERLAP 可使调度器更早处理前一个 Prefill 的结果,以改善其 TTFT。本文版本该变量默认是 False。Overlap 并不限于 Decode,但不同执行模式的依赖和延迟目标不同。
5. 性能与验证
5.1 加速条件
设每轮 CPU 调度及结果处理耗时为
例如,假设
当
5.2 官方性能证据
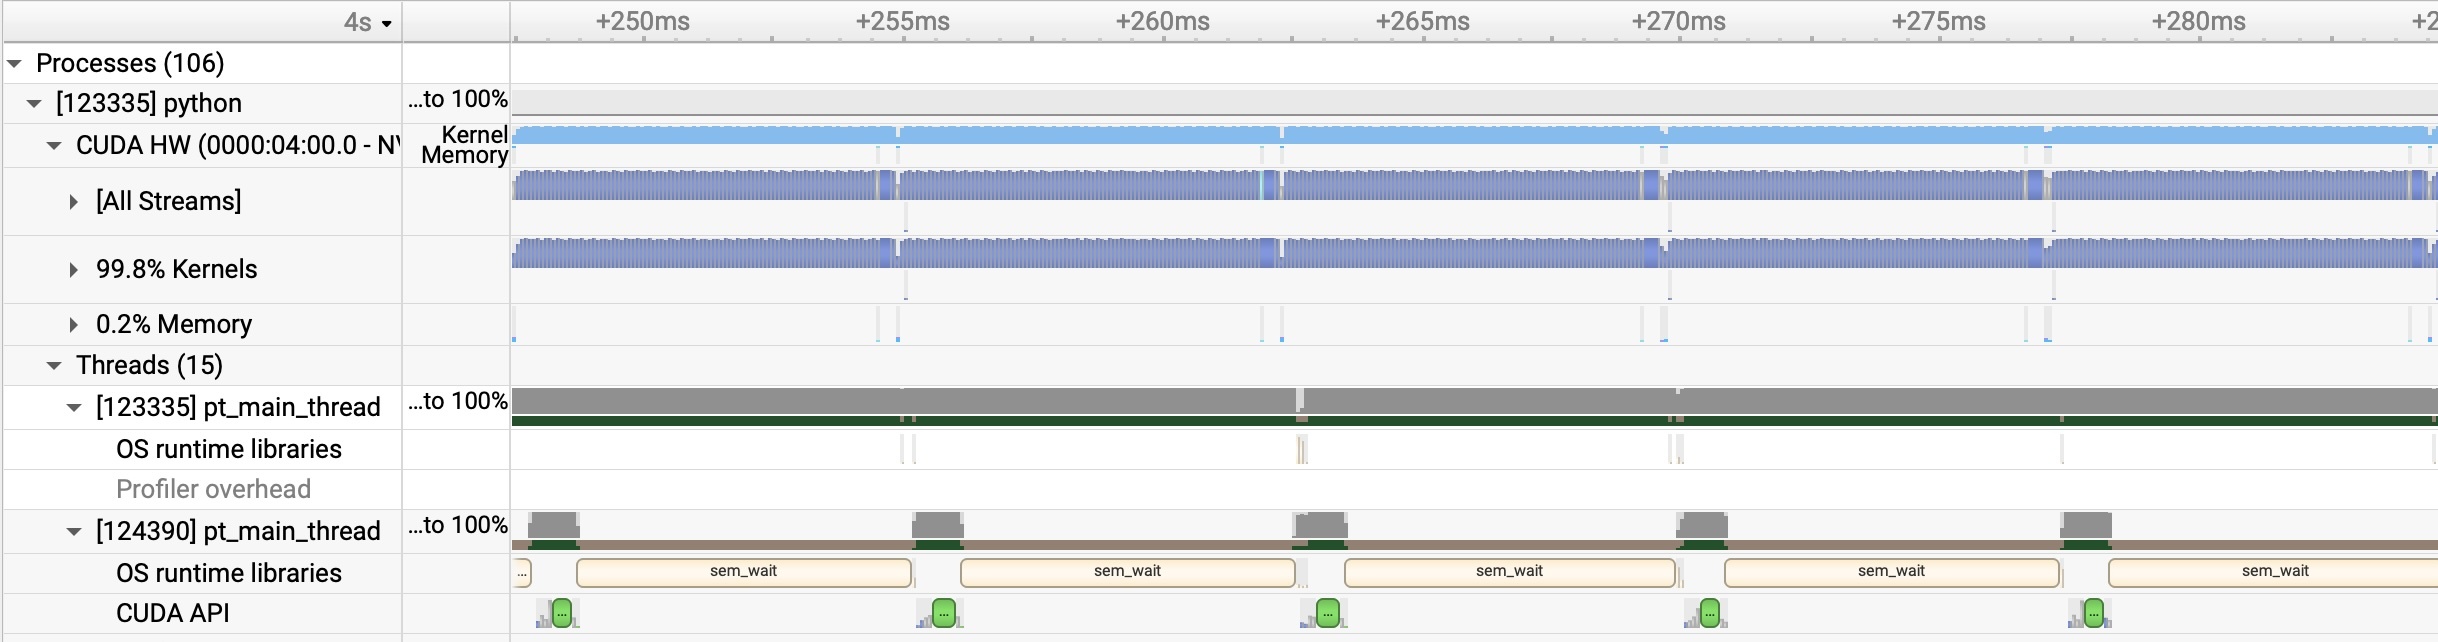
图 3:SGLang v0.4 发布时的 Nsight Systems 截图,点击可查看大图。来源:官方性能说明。
官方报告这一优化相对上一版本获得约
5.3 对照验证
在支持的配置下,Overlap Scheduler 默认启用,可通过 --disable-overlap-schedule 关闭。做 A/B 对照时应保持模型、后端、CUDA Graph、TP、请求长度和并发度相同,完成预热后比较:
- GPU 时间线:相邻 Decode Kernel 之间的空隙是否减少。
- CPU 时间线:结果处理和下一轮准备是否与 GPU 计算重叠。
- 吞吐与延迟:输出 token/s、TPOT、TTFT 及其尾部延迟是否改善。
- 同步点:是否在下一轮提交前出现结果读取、序列长度回传或其他主机等待。
只看到某次 synchronize() 耗时,不能直接判定 Overlap 无效;需要同时查看 GPU 是否正在执行已提交的下一轮。本节描述验证方法,本文未执行 GPU 性能测试。
6. 相关机制
| 机制 | 优化对象 | 与 Overlap Schedule 的关系 |
|---|---|---|
| CUDA Graph | 降低重复提交多个 GPU Kernel 的开销 | 可配合使用;调度及结果处理仍需单独安排 |
| Speculative Decoding | 一轮验证多个候选 token | 增加了接受长度与 Draft 状态的依赖 |
| Two-Batch Overlap(TBO) | 交错两个 Micro-batch 的计算与通信 | 常用于 MoE 的 Dispatch/Combine 通信隐藏,属于另一层重叠 |
| PD 分离 | 将 Prefill 与 Decode 放在不同实例 | 改变部署和资源分工,各实例仍需要调度 |
SGLang 的 --enable-two-batch-overlap 控制 TBO;本文讨论的 CPU–GPU 调度由 --disable-overlap-schedule 控制。二者名称相近,但前者主要处理设备计算与通信的交错,后者处理主机调度与设备执行的流水线。