硬件架构
从 CUDA 程序的视角看,NVIDIA GPU 由 GPC、SM、缓存、设备显存和互联组成。本文只建立计算、存储和通信三条硬件主线,并说明 CUDA 执行对象如何映射到这些资源;线程调度、内存空间和指令体系分别由子专题展开。
1. 整体拓扑
离散 GPU 与 CPU 共同组成异构系统。CPU 及其直接连接的 System Memory 属于 Host,GPU 及其直接连接的 GPU DRAM 属于 Device,两者通常通过 PCIe 或 NVLink 互联。
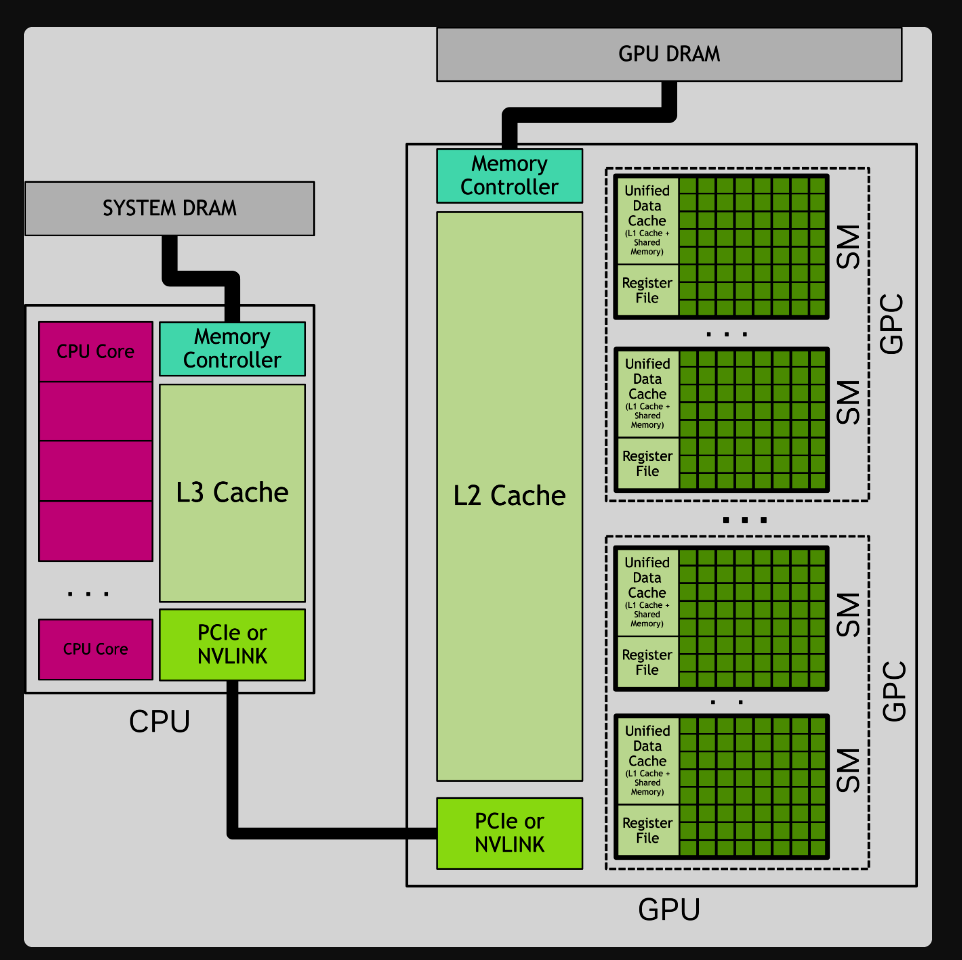
图 1:CPU、GPU、DRAM、GPC、SM 与缓存的概念关系。参考 NVIDIA CUDA Programming Guide:GPU Hardware Model。
GPU 内部可以概括为:
text
GPU
├─ GPC × N
│  └─ SM × M
│     ├─ Functional Units
│     ├─ Register File
│     └─ Unified L1 / Shared Memory
├─ Shared L2 Cache
├─ Memory Controllers
└─ GPU DRAM:HBM / GDDR
2. 计算单元
GPC(Graphics Processing Cluster)组织一组物理上相近的 SM(Streaming Multiprocessor)。SM 是普通 Thread Block 的执行场所,负责管理 Warp,并把就绪指令发送到不同执行管线。
text
GPC
  → SM
      → SMSP / Warp Scheduler
→ Integer / Floating Point / Load-Store / SFU / Tensor Core- Integer 与 Floating Point Units:执行索引、地址、标量算术、Element-wise 和部分归约。
- Load/Store Units:负责 Register 之外的主要数据访问。
- Special Function Units:执行部分超越函数和特殊数学运算。
- Tensor Cores:执行固定 Tile 的矩阵乘加,是 GEMM 和 Attention 的主要计算资源。
3. 存储单元
数据从设备显存进入执行单元时,会依次经过共享缓存和片上存储:
text
HBM / GDDR
  → Memory Controller
      → L2 Cache
          → Unified L1 / Shared Memory
              → Register File
→ Execution Units- Register File:保存线程局部值和 Warp 执行状态。
- Unified L1 / Shared Memory:位于 SM 内;L1 由硬件缓存,Shared Memory 由 Kernel 显式管理。
- L2 Cache:由整张 GPU 的 SM 共享,汇聚发往设备显存的访问。
- Memory Controller:把 L2 请求调度到不同显存 Channel、Bank 和 Row。
- HBM/GDDR:保存模型权重、KV Cache、Activation 和 Workspace。
4. 通信路径
单卡之外的数据流由系统拓扑决定:
| 机制 | 连接对象 | 主要作用 |
|---|---|---|
| PCIe | CPU、GPU、NIC、NVMe 等设备 | Host-to-Device 和部分 GPU/设备 P2P |
| NVLink | GPU、Grace CPU 或 NVSwitch | 高带宽 Peer-to-Peer 连接 |