SM
SM(Streaming Multiprocessor)是 NVIDIA GPU 接收 Thread Block、管理 Warp 并发并向执行管线发射指令的核心硬件单元。理解 SM 的关键不是记住某一代 GPU 的核心数量,而是看清 Block → Warp → SMSP → 执行单元 的调度路径,以及寄存器和 Shared Memory 如何限制并发驻留。
1. 内部结构
现代 NVIDIA GPU 会把一个 SM 进一步划分为若干 SM Subpartition(SMSP)。下面是面向 CUDA 性能分析的逻辑结构:
SM
├─ SMSP 0
│  ├─ Warp Scheduler / Dispatch
│  ├─ Warp Pool
│  ├─ Register File
│  └─ Integer / Floating Point / Load-Store / SFU / Tensor Core
├─ SMSP 1 ... N
└─ SM 共享资源
   └─ Unified L1 Data Cache / Shared Memory
关键点:
- 一个 Warp 被分配到某个 SMSP 后,通常在其生命周期内留在该分区。
- 每个 SMSP 管理自己的 Warp Pool、寄存器和部分执行管线。
- Unified L1 Data Cache/Shared Memory 等资源则在 SM 范围内共享。
2. Block
一个普通 Thread Block 整体驻留在同一个 SM 上。SM 接收 Block 后,按线程 ID 把它切分为 Warp:
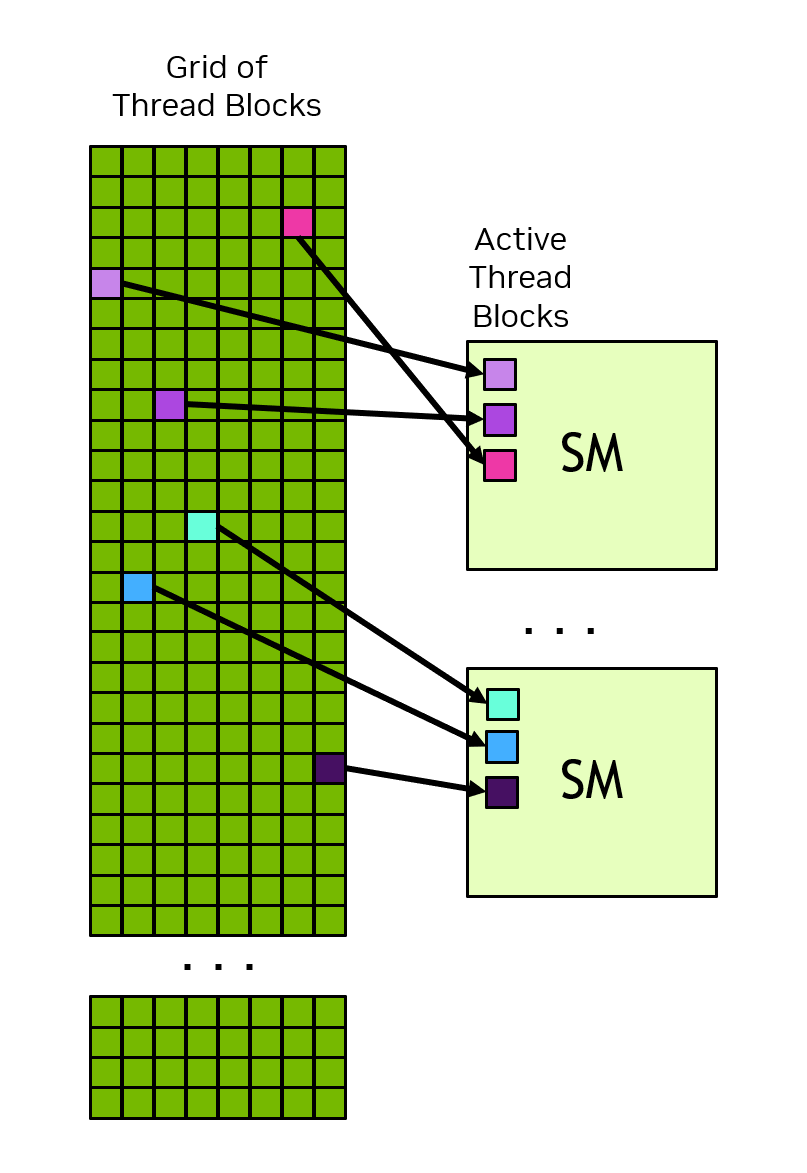
图 1:Grid 中的 Thread Block 以任意顺序调度到可用 SM;一个 SM 可以并发驻留多个 Block。图源:NVIDIA CUDA Programming Guide。
其中,
一个 SM 可以同时驻留多个 Block。实际可驻留数量由多个上限共同决定:
其中:
:架构允许的最大驻留 Block 数; :每个 SM 的最大驻留线程数; 、 :SM 总寄存器和单个 Block 分配的寄存器; 、 :SM 可用 Shared Memory 和单个 Block 使用量。
当单个 Block 不使用某类资源时,应忽略该资源对应的除法项。真实分配还受 Warp、寄存器和 Shared Memory 的硬件分配粒度影响,因此公式给出的是理解资源边界的近似形式,精确结果应通过 CUDA Occupancy API 或 Nsight Compute 查询。
3. Warp
Warp 的执行状态可以沿调度过程理解:
Resident / Active Warp
  → Eligible Warp
      → Selected / Issued Warp
→ Stalled Warp- Active Warp:已经驻留在 SMSP 的 Warp,包括可发射和等待中的 Warp。
- Eligible Warp:下一条指令已解码,输入依赖已满足,目标执行管线也可接收指令。
- Selected / Issued Warp:从 Eligible Warp 中被调度器选中,并在当前发射周期提交指令。
- Stalled Warp:因数据依赖、内存访问、执行管线占用或同步等原因暂时不能发射。
切换逻辑:每个周期,Warp Scheduler 会检查其 Warp Pool,从 Eligible Warp 中选择一个或多个 Warp 发射,若当前 Warp 因 HBM 访问等待数百个周期,调度器可以切换到另一个已就绪 Warp、
4. 执行单元
Warp Scheduler 发射指令后,指令进入匹配的执行管线:
| 执行资源 | 主要工作 | 大模型推理中的典型操作 |
|---|---|---|
| Integer Execution Units | 整数算术、索引和地址相关计算 | Offset、Mask、量化整数运算 |
| Floating Point Execution Units | FP32/FP64 等普通浮点运算 | Element-wise、归一化、部分归约 |
| Load/Store Units | Global、Local、Shared Memory 访问 | 权重、Activation、KV Cache 搬运 |
| Special Function Units | 近似超越函数和特殊数学运算 | exp、倒数、平方根等 |
| Tensor Cores | 矩阵 Tile 乘加 | GEMM、Attention 中的矩阵乘法 |
5. Register File
Register File 保存 Warp 的线程状态和局部值。CUDA C++ 中的标量局部变量通常由编译器分配到寄存器,但源码变量与物理寄存器并非一一对应;编译器会进行生命周期分析、复用和指令级优化。
寄存器使用同时影响两件事:
- 单线程执行效率:中间值留在寄存器中,可以避免更高延迟的存储访问。
- 并发驻留能力:每线程寄存器数增加后,同一个 SM 可同时容纳的 Block 和 Warp 可能减少。
当编译器无法把局部值保留在寄存器中时,会生成 Local Memory Load/Store。Local Memory 是线程私有的 CUDA 地址空间,但通常位于设备显存中,并通过缓存访问;Register Spill 因此可能显著增加存储流量。
可以在编译阶段查看寄存器与 Spill 信息:
nvcc -arch=sm_90 -Xptxas=-v kernel.cu限制寄存器数量有时能提高 Occupancy,但也可能引入更多 Spill。优化时应以 Kernel 时间和 Nsight Compute 指标为准,而不是单独追求更低的寄存器数。