MoE
Mixture of Experts(MoE)使用多个独立专家扩展模型容量,并通过 Router 为每个 token 选择少量专家执行计算,从而将总参数量与单 token 激活参数量解耦。本文先说明 MoE 的通用数据流,再以 Qwen3.5-397B-A17B 为参考实现,介绍 Router、Routed Experts、Shared Expert 与输出聚合。
1. 整体架构
MoE 通常替换 Decoder Layer 中的 Dense FFN,Attention 或其他 Token Mixer 结构保持不变。对于每个 token,Router 负责选择专家并生成路由权重,Routed Experts 只处理分配给自己的 token;部分模型还会增加始终激活的 Shared Expert。
1.1 Qwen3.5 配置
Qwen3.5-397B-A17B 在全部 60 个 Decoder Layer 中使用 MoE,其配置如下:
| 配置 | 数值 |
|---|---|
| 隐藏维度 | 4096 |
| Routed Experts 数量 | 512 |
| 每个 token 激活的 Routed Experts 数量 | 10 |
| Shared Expert 数量 | 1 |
| 专家中间维度 | 1024 |
| Decoder Layer 数量 | 60 |
这些数值属于该模型的具体配置,不是所有 MoE 模型的固定设计。
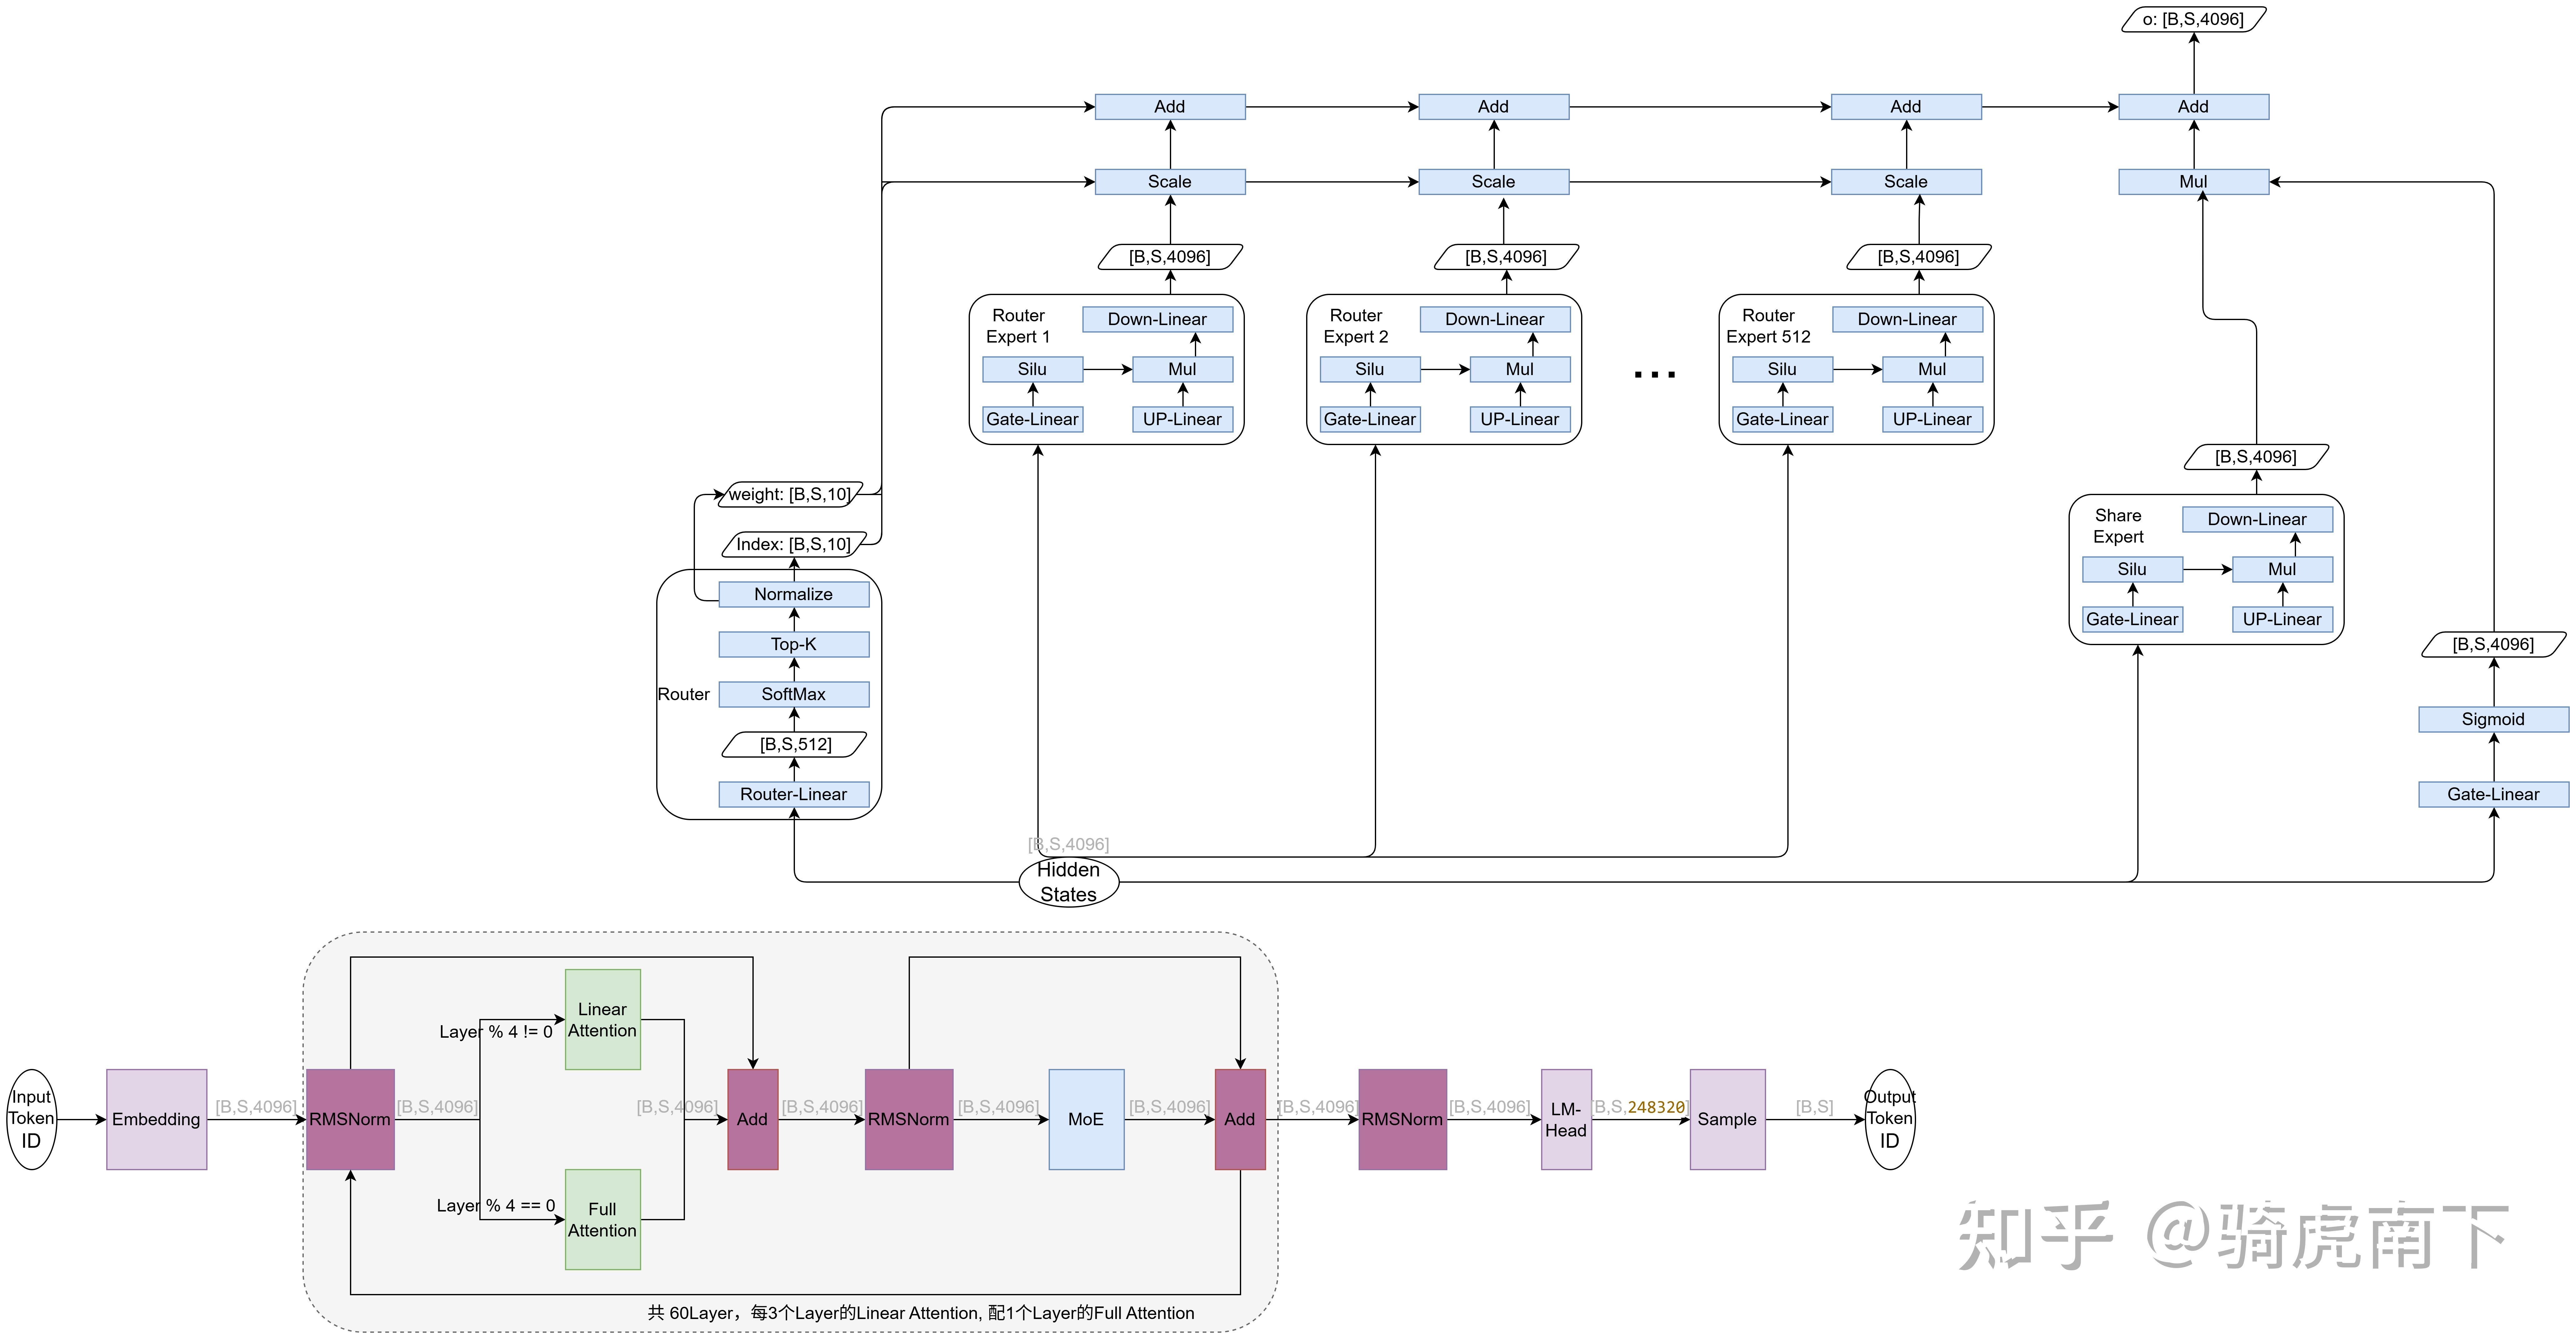
1.2 单层流程
Qwen3.5-397B-A17B 按照 3 层 Gated DeltaNet 加 1 层 Full Attention 的模式重复 15 次,每层 Token Mixer 之后都执行 MoE:
Hidden States
  → RMSNorm
  → Gated DeltaNet / Full Attention
  → Residual Add
  → RMSNorm
  → MoE
      ├─ Shared Expert
      └─ Router → Top-10 → Routed Experts
  → Branch Add
  → Residual Add
2. Router
设 MoE 输入为
对于 token
其中,selected_experts 与 routing_weights 的形状均为 [T, 10]。Softmax 使用 float32 计算,最终路由权重再转换回模型数据类型;Shared Expert 不参与 Top-k。
📄 transformers/.../modeling_qwen3_5_moe.py#L779-L796
class Qwen3_5MoeTopKRouter(nn.Module):
    def __init__(self, config):
        super().__init__()
        self.top_k = config.num_experts_per_tok
        self.num_experts = config.num_experts
        self.hidden_dim = config.hidden_size
        self.weight = nn.Parameter(torch.zeros(self.num_experts, self.hidden_dim))

    def forward(self, hidden_states):
        hidden_states = hidden_states.reshape(-1, self.hidden_dim)
        router_logits = F.linear(hidden_states, self.weight)
        router_probs = torch.nn.functional.softmax(router_logits, dtype=torch.float, dim=-1)
        router_top_value, router_indices = torch.topk(router_probs, self.top_k, dim=-1)
        router_top_value /= router_top_value.sum(dim=-1, keepdim=True)
        router_top_value = router_top_value.to(router_logits.dtype)
        router_scores = router_top_value
        return router_logits, router_scores, router_indices
3. 专家计算
Qwen3.5 的 Shared Expert 与 Routed Experts 都是 SwiGLU MLP。单个专家
所有专家均使用 4096 → 1024 → 4096 的投影维度,但参数彼此独立。
3.1 Shared Expert
Shared Expert 读取全部 token,不经过 Router 选择。它用于学习跨 token 共享的特征,其输出在聚合前还会乘以一个由输入计算的标量门控。
3.2 Routed Experts
每个 Routed Expert 只处理当前批次中路由到自己的 token。Transformers 参考实现先找出本批次命中的专家,再按专家收集 token、执行 SwiGLU,并将加权结果累加回对应位置:
📄 transformers/.../modeling_qwen3_5_moe.py#L740-L776
for expert_idx in expert_hit:
    expert_idx = expert_idx[0]
    if expert_idx == self.num_experts:
        continue
    top_k_pos, token_idx = torch.where(expert_mask[expert_idx])
    current_state = hidden_states[token_idx]

    gate, up = F.linear(
        current_state,
        self.gate_up_proj[expert_idx],
    ).chunk(2, dim=-1)
    current_hidden_states = self.act_fn(gate) * up
    current_hidden_states = F.linear(
        current_hidden_states,
        self.down_proj[expert_idx],
    )
    current_hidden_states *= top_k_weights[token_idx, top_k_pos, None]

    final_hidden_states.index_add_(
        0,
        token_idx,
        current_hidden_states.to(final_hidden_states.dtype),
    )
因此,512 表示可选的 Routed Experts 总数,而单个 token 只执行其中 10 个。
4. 输出聚合
设
Shared Expert 的输出由标量门控调节:
两条专家分支相加得到 MoE 输出,再与残差相加:
📄 transformers/.../modeling_qwen3_5_moe.py#L798-L817
hidden_states_reshaped = hidden_states.view(-1, hidden_dim)

shared_expert_output = self.shared_expert(hidden_states_reshaped)
_, routing_weights, selected_experts = self.gate(hidden_states_reshaped)
expert_output = self.experts(hidden_states_reshaped, selected_experts, routing_weights)

shared_expert_output = (
    torch.sigmoid(self.shared_expert_gate(hidden_states_reshaped))
    * shared_expert_output
)
expert_output = expert_output + shared_expert_output
return expert_output.reshape(batch_size, sequence_length, hidden_dim)