LLM
Decoder-only Transformer 通过因果注意力逐 token 建模,并以自回归方式生成文本。本文先说明这类模型的通用推理流程,再以 Qwen2 为参考实现,介绍 RMSNorm、Grouped-Query Attention(GQA)、RoPE 与 SwiGLU 等具体组件。
1. 整体架构
Decoder-only LLM 的推理主干由输入处理、Decoder Layer 堆叠和输出处理三部分组成:
Text
  → Tokenizer
  → Token Embedding
  → N × Decoder Layer
      → Pre-Norm → Causal Self-Attention → Residual Add
      → Pre-Norm → Feed-Forward Network → Residual Add
  → Final Norm
  → LM Head
  → Logits Processing
  → Token Selection
  → Next Token
其中,因果掩码保证每个位置只能访问当前及之前的 token。生成阶段每次选择一个新 token,并将其追加到序列中,重复执行上述流程,直至满足停止条件。
Qwen2 沿用这条通用主干,其参考架构如下:
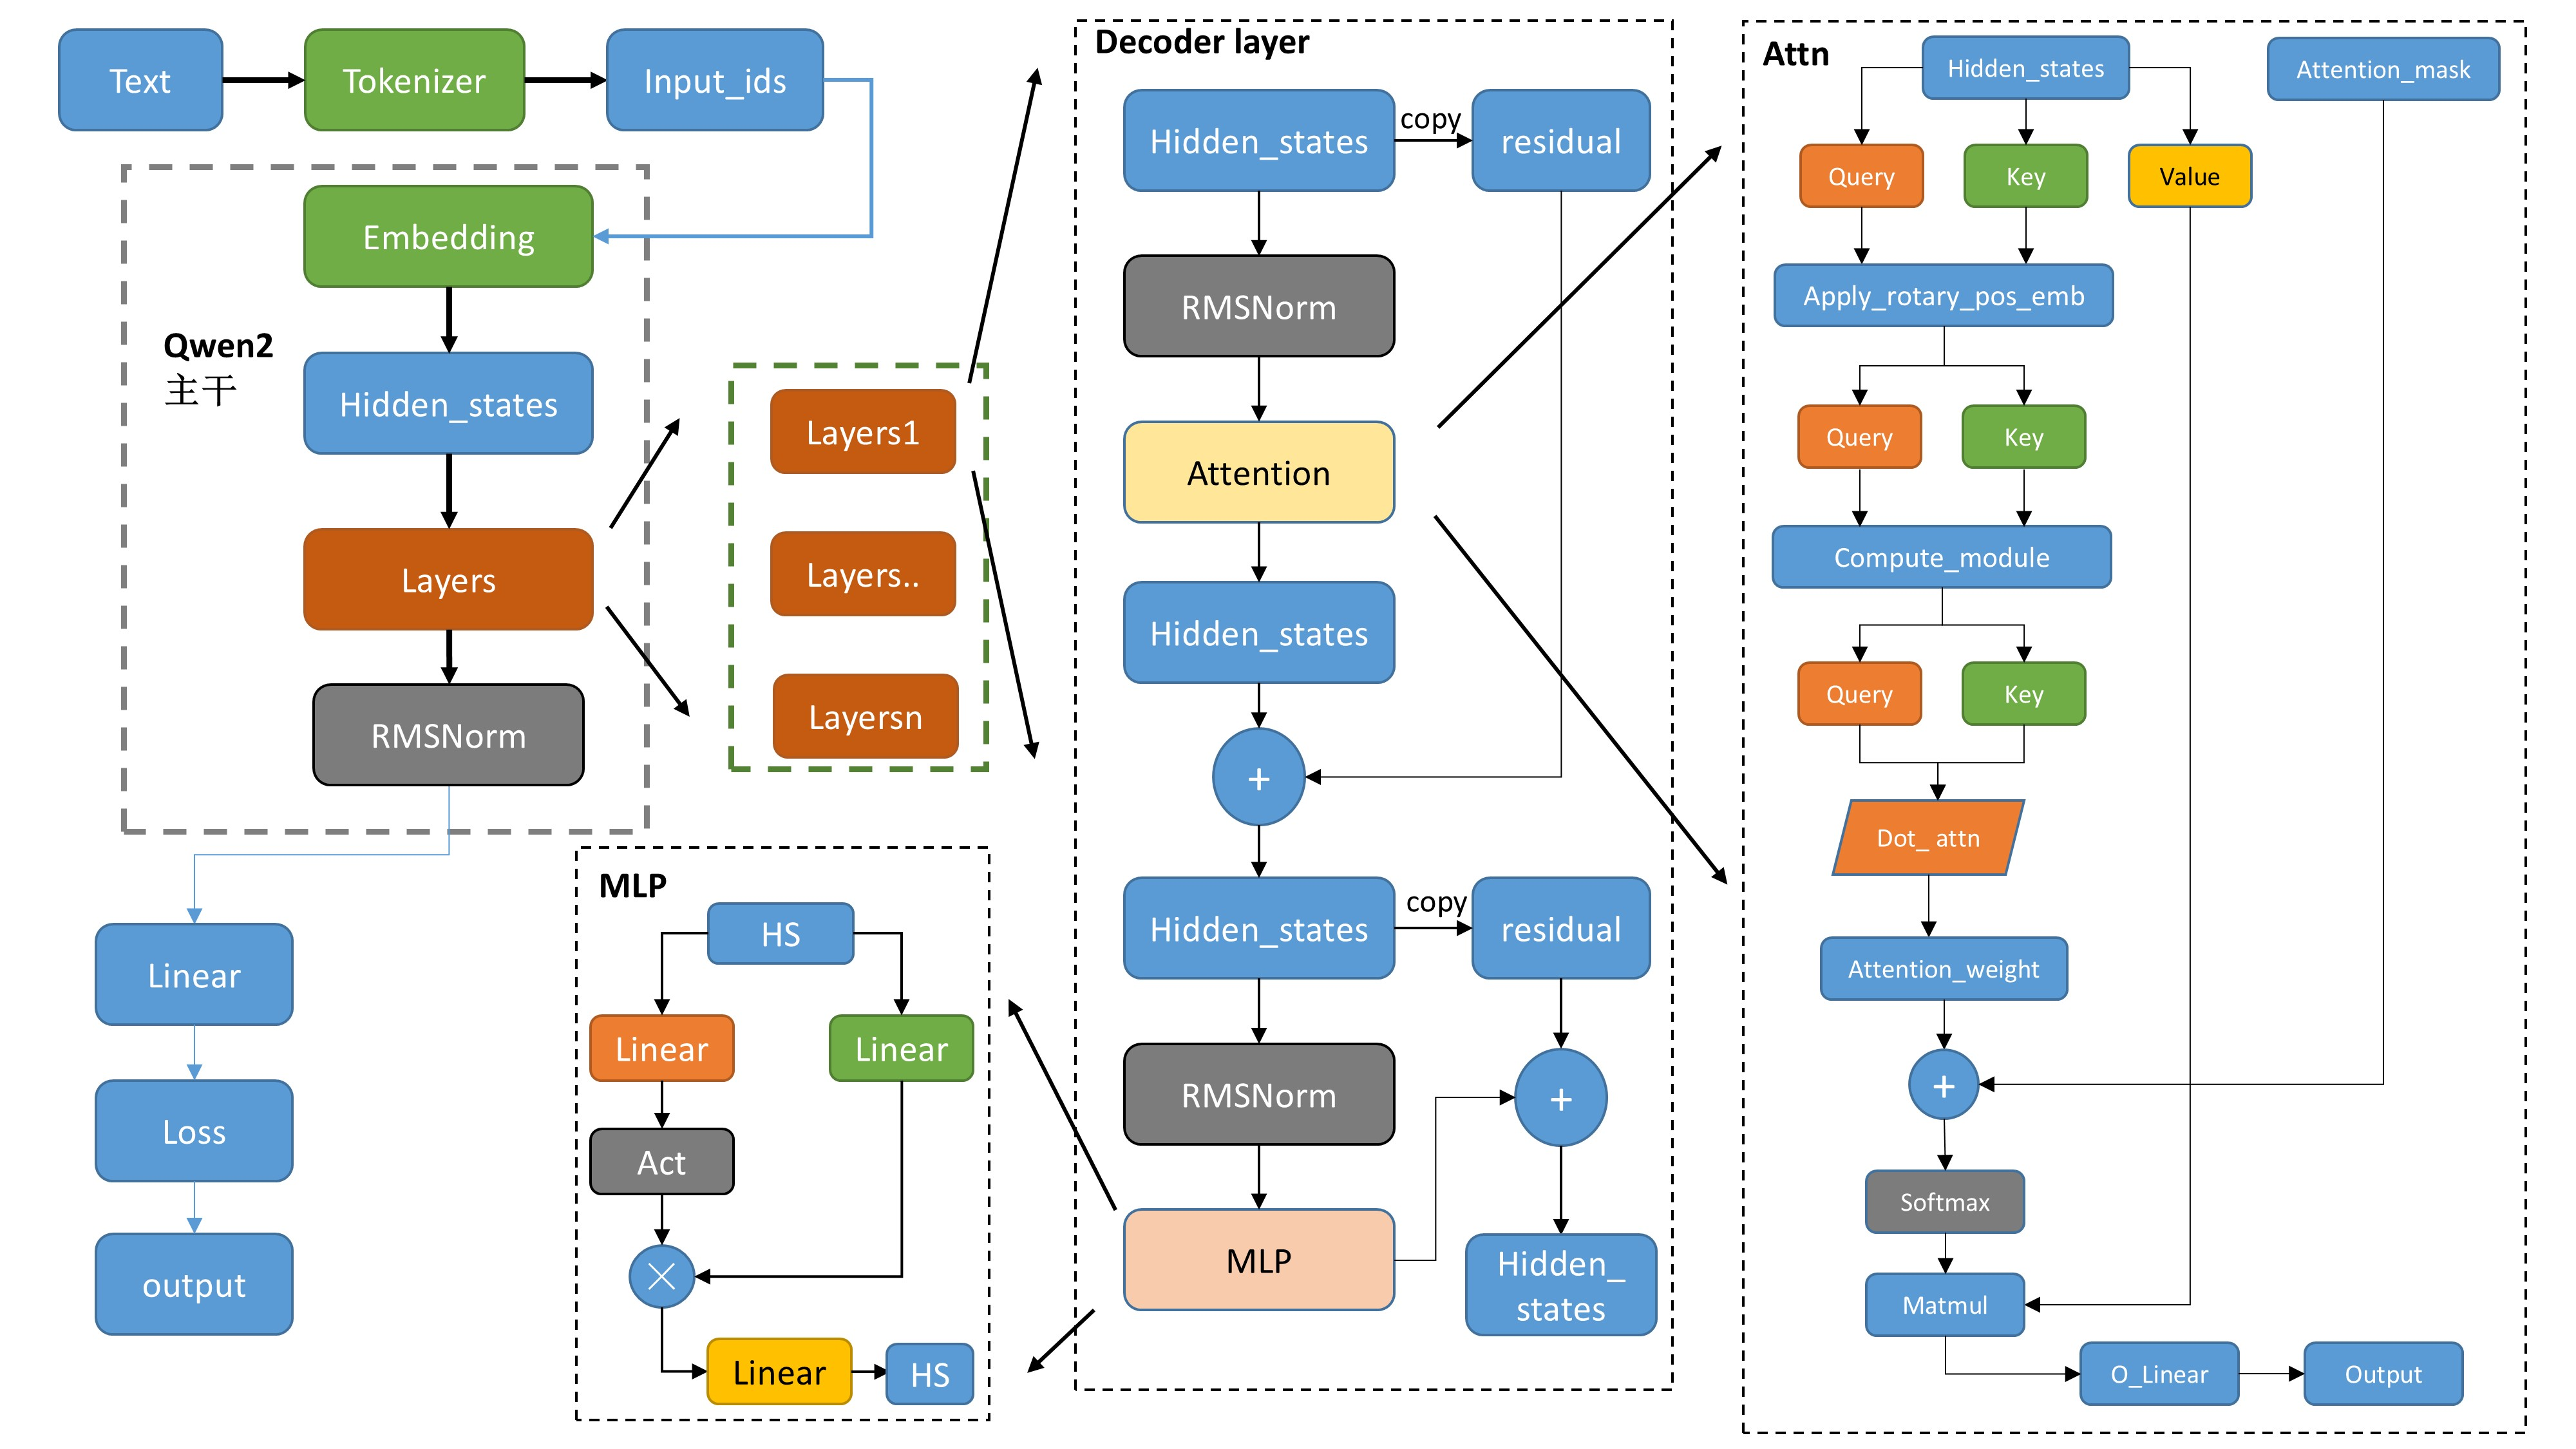
2. 输入处理
输入处理将原始文本转换为 Decoder Layer 接收的隐藏状态,依次包含 Tokenizer 与 Token Embedding。
2.1 Tokenizer
Tokenizer 根据词表和切分规则将文本编码为 token ID。对于批大小 input_ids 的形状为 [B, L]。Tokenizer 位于神经网络之外,其词表、切分算法和特殊 token 均由具体模型定义。
Qwen2 使用 Byte-level BPE,并通过 Hugging Face tokenizers 实现预切分、字节编码和 BPE 合并。
📄 transformers/.../tokenization_qwen2.py#L36-L70
class Qwen2Tokenizer(TokenizersBackend):
    model_input_names = ["input_ids", "attention_mask"]
    model = BPE

    def __init__(self, vocab, merges, unk_token="<|endoftext|>", ...):
        self._tokenizer = Tokenizer(
            BPE(vocab=self._vocab, merges=self._merges, byte_fallback=False, ...)
        )
        self._tokenizer.pre_tokenizer = pre_tokenizers.Sequence([
            pre_tokenizers.Split(Regex(PRETOKENIZE_REGEX), behavior="isolated", ...),
            pre_tokenizers.ByteLevel(add_prefix_space=False, ...),
        ])
        self._tokenizer.decoder = decoders.ByteLevel()
2.2 Token Embedding
Token Embedding 使用参数矩阵
其中,tie_word_embeddings=False,因此输入 Embedding 与输出 LM Head 使用两组独立参数;其他模型或检查点可以共享两组权重。
📄 transformers/.../modeling_qwen2.py#L332-L348
class Qwen2Model(Qwen2PreTrainedModel):
    def __init__(self, config: Qwen2Config):
        super().__init__(config)
        self.embed_tokens = nn.Embedding(
            config.vocab_size,
            config.hidden_size,
            self.padding_idx,
        )
        self.layers = nn.ModuleList(
            [Qwen2DecoderLayer(config, layer_idx) for layer_idx in range(config.num_hidden_layers)]
        )
        self.norm = Qwen2RMSNorm(config.hidden_size, eps=config.rms_norm_eps)
        self.rotary_emb = Qwen2RotaryEmbedding(config=config)
3. Decoder Layer
Decoder-only Transformer 重复堆叠
Qwen2 使用 Pre-Norm。设第
Pre-Norm 将归一化放在子模块之前,残差分支则直接连接该子模块的输入与输出。
📄 transformers/.../modeling_qwen2.py#L269-L309
class Qwen2DecoderLayer(GradientCheckpointingLayer):
    def __init__(self, config: Qwen2Config, layer_idx: int):
        super().__init__()
        self.self_attn = Qwen2Attention(config=config, layer_idx=layer_idx)
        self.mlp = Qwen2MLP(config)
        self.input_layernorm = Qwen2RMSNorm(config.hidden_size, eps=config.rms_norm_eps)
        self.post_attention_layernorm = Qwen2RMSNorm(config.hidden_size, eps=config.rms_norm_eps)

    def forward(self, hidden_states, attention_mask, past_key_values, ...):
        residual = hidden_states
        hidden_states = self.input_layernorm(hidden_states)
        hidden_states, _ = self.self_attn(
            hidden_states=hidden_states,
            attention_mask=attention_mask,
            past_key_values=past_key_values,
            ...
        )
        hidden_states = residual + hidden_states

        residual = hidden_states
        hidden_states = self.post_attention_layernorm(hidden_states)
        hidden_states = self.mlp(hidden_states)
        hidden_states = residual + hidden_states
        return hidden_states
3.1 RMSNorm
归一化方法与归一化位置是两个独立的架构选择。Qwen2 在每个子模块之前和全部 Decoder Layer 之后使用 RMSNorm:
其中,
实现时,Qwen2 先将输入转换为 float32 计算均方值,再恢复原始数据类型,以降低低精度计算的数值误差。
📄 transformers/.../modeling_qwen2.py#L249-L266
class Qwen2RMSNorm(nn.Module):
    def __init__(self, hidden_size, eps: float = 1e-6) -> None:
        super().__init__()
        self.weight = nn.Parameter(torch.ones(hidden_size))
        self.variance_epsilon = eps

    def forward(self, hidden_states: torch.Tensor) -> torch.Tensor:
        input_dtype = hidden_states.dtype
        hidden_states = hidden_states.to(torch.float32)
        variance = hidden_states.pow(2).mean(-1, keepdim=True)
        hidden_states = hidden_states * torch.rsqrt(variance + self.variance_epsilon)
        return self.weight * hidden_states.to(input_dtype)
3.2 Causal Self-Attention
Causal Self-Attention 先将隐藏状态投影为 Query、Key 和 Value,再计算带因果掩码的缩放点积注意力。设 Query 头数为
Qwen2 通过 num_attention_heads 和 num_key_value_heads 配置头数。当
Attention 的核心计算为:
其中,因果掩码
因此,Query 与 Key 的点积能够编码相对位置。生成阶段,历史 Key 和 Value 可以写入 KV Cache,后续步骤只需计算新增 token 对应的投影。
📄 transformers/.../modeling_qwen2.py#L187-L245
class Qwen2Attention(nn.Module):
    def __init__(self, config: Qwen2Config, layer_idx: int):
        ...
        self.num_key_value_groups = config.num_attention_heads // config.num_key_value_heads
        self.scaling = self.head_dim**-0.5
        self.q_proj = nn.Linear(config.hidden_size, config.num_attention_heads * self.head_dim, bias=True)
        self.k_proj = nn.Linear(config.hidden_size, config.num_key_value_heads * self.head_dim, bias=True)
        self.v_proj = nn.Linear(config.hidden_size, config.num_key_value_heads * self.head_dim, bias=True)
        self.o_proj = nn.Linear(config.num_attention_heads * self.head_dim, config.hidden_size, bias=False)

    def forward(self, hidden_states, position_embeddings, attention_mask, past_key_values, ...):
        query_states = self.q_proj(hidden_states).view(hidden_shape).transpose(1, 2)
        key_states = self.k_proj(hidden_states).view(hidden_shape).transpose(1, 2)
        value_states = self.v_proj(hidden_states).view(hidden_shape).transpose(1, 2)

        cos, sin = position_embeddings
        query_states, key_states = apply_rotary_pos_emb(query_states, key_states, cos, sin)

        if past_key_values is not None:
            key_states, value_states = past_key_values.update(
                key_states,
                value_states,
                self.layer_idx,
            )

        attn_output, attn_weights = attention_interface(
            self,
            query_states,
            key_states,
            value_states,
            attention_mask,
            scaling=self.scaling,
            ...
        )
        return self.o_proj(attn_output.reshape(*input_shape, -1)), attn_weights
更多注意力机制及实现变体见 Attention。
3.3 SwiGLU MLP
Feed-Forward Network 负责对每个 token 的隐藏状态独立执行非线性变换。Qwen2 使用 SwiGLU,其计算过程为:
gate_proj 与 up_proj 将最后一维从 hidden_size 扩展到 intermediate_size;两路结果逐元素相乘后,down_proj 再将其映射回 hidden_size。该过程不改变批大小和序列长度。
📄 transformers/.../modeling_qwen2.py#L35-L48
class Qwen2MLP(nn.Module):
    def __init__(self, config):
        super().__init__()
        self.gate_proj = nn.Linear(self.hidden_size, self.intermediate_size, bias=False)
        self.up_proj = nn.Linear(self.hidden_size, self.intermediate_size, bias=False)
        self.down_proj = nn.Linear(self.intermediate_size, self.hidden_size, bias=False)
        self.act_fn = ACT2FN[config.hidden_act]

    def forward(self, x):
        return self.down_proj(self.act_fn(self.gate_proj(x)) * self.up_proj(x))
4. 输出处理
经过全部 Decoder Layer 后,隐藏状态依次经过 Final RMSNorm 与 LM Head。对于最后一个位置的隐藏状态
推理框架随后对 logits 应用温度缩放、Top-k、Top-p 等处理策略,并通过贪心或采样选择下一个 token。新 token 被追加到输入序列后,模型继续执行下一轮解码;遇到终止 token、达到长度上限或满足其他停止条件时结束生成。
完整的输出流程见 Output:从 Decoder 输出到文本。