CUDA
CUDA 用线程、Thread Block 和 Grid 表达大规模并行任务,再由 GPU 把这些逻辑任务映射到 SM、Warp 和执行单元。本文从 Kernel 启动出发,说明 Grid、Block、Cluster、SIMT 与 Tile Programming,以及 CUDA C++、PTX 与 SASS 之间的关系。
1. 编程模型
CUDA 程序同时包含 Host Code 和 Device Code。Host Code 在 CPU 上运行,负责分配内存、搬运数据并启动 Kernel;Device Code 编译后在 GPU 上执行。
下面的 SAXPY Kernel 为每个元素启动一个逻辑线程:
__global__ void saxpy(float a, const float* x, float* y, int n) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < n) {
        y[i] = a * x[i] + y[i];
    }
}

int threads = 256;
int blocks = (n + threads - 1) / threads;
saxpy<<<blocks, threads>>>(a, x, y, n);
<<<blocks, threads>>> 定义一维 Grid 中的 Thread Block 数量,以及每个 Block 的线程数。Kernel 内通过 blockIdx、blockDim 和 threadIdx 计算当前线程负责的数据位置。二维和三维 Grid/Block 只是索引组织方式,硬件最终仍会把 Block 线性化为线程,并进一步组成 Warp。
2. 执行层级
CUDA 的程序层级是 Grid → Thread Block → Thread;Warp 是 Thread Block 映射到 NVIDIA 硬件后的基本执行批次:
Kernel Launch
  → Grid
      → Thread Block / CTA
          → Warp
              → 32 × Thread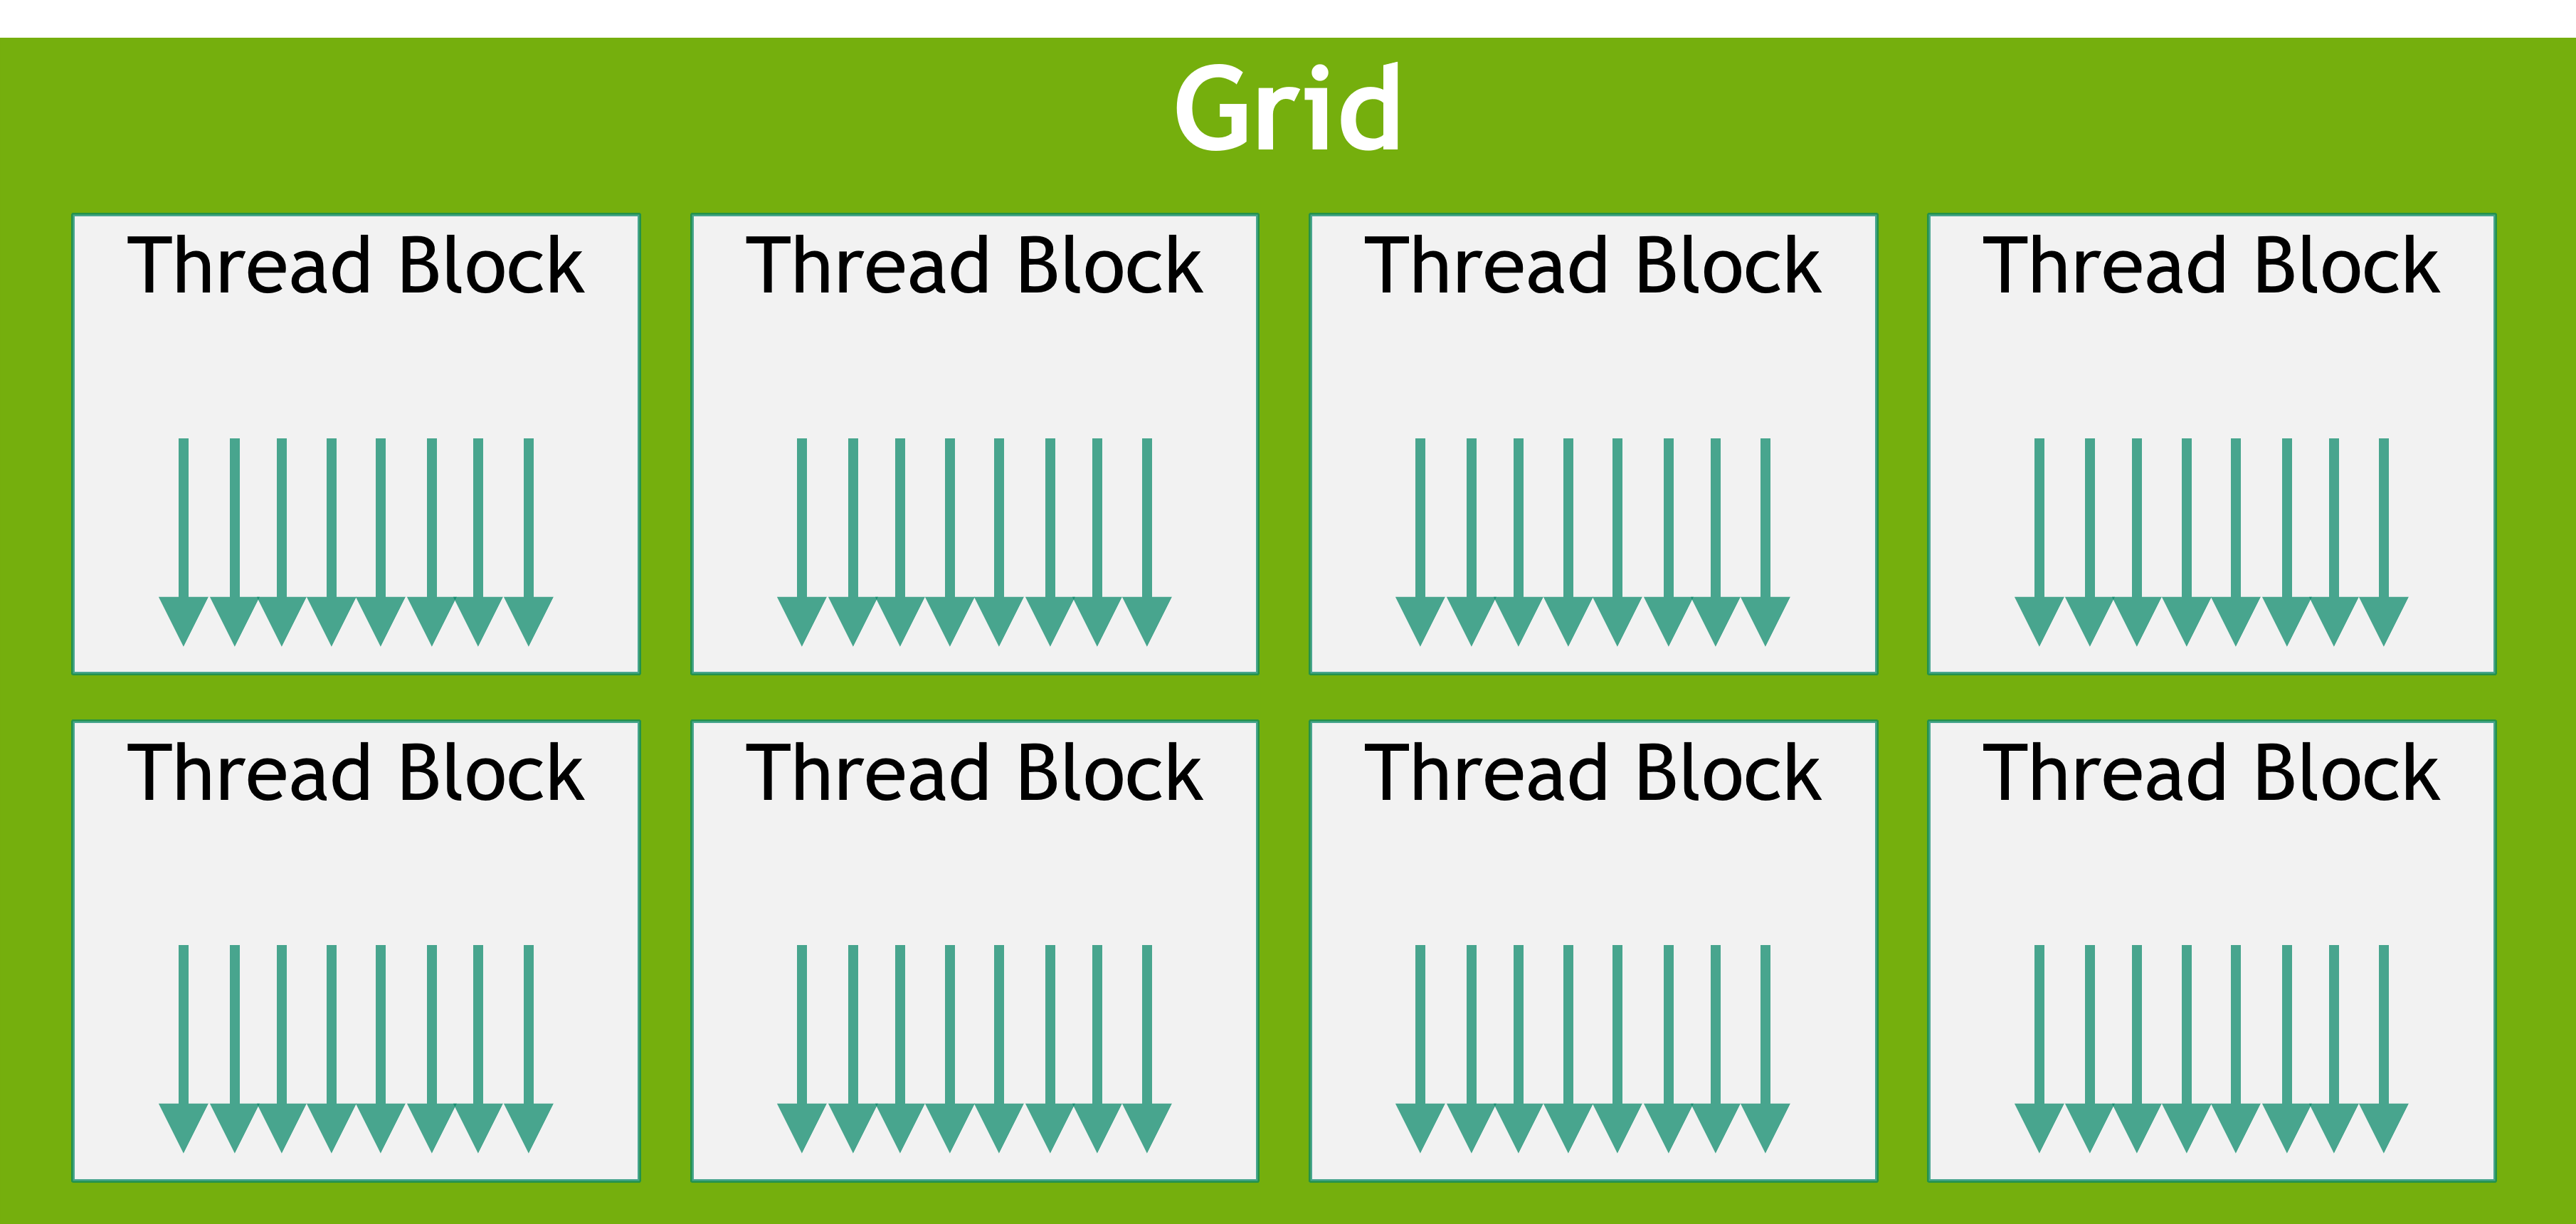
图 1:Grid、Thread Block 与 Thread 的逻辑层级。图源:NVIDIA CUDA Programming Guide。
| 层级 | 作用 | 调度与资源关系 |
|---|---|---|
| Grid | 一次 Kernel 启动产生的全部线程 | 包含一个或多个 Thread Block |
| Thread Block / CTA | 可协作和同步的线程组 | 整个 Block 驻留在同一个 SM 上 |
| Warp | NVIDIA GPU 的 SIMT 执行批次 | 由 Block 中连续的 32 个线程组成 |
| Thread | CUDA 暴露的基本并行单元 | 拥有独立索引、寄存器状态和控制流 |
CTA(Cooperative Thread Array)与 CUDA Thread Block 指同一层级。
2.1 Block 独立性
一个普通 Block 的全部线程在同一个 SM 上执行;只要资源允许,一个 SM 可以同时驻留多个 Block。不同 Block 的调度顺序没有保证,它们可以并行、串行或以任意次序执行,因此普通 Kernel 不能依赖跨 Block 的隐式同步。
Block 独立性让同一 Grid 能够适配不同 SM 数量:GPU 只需持续把尚未执行的 Block 分配给空闲 SM。Block 到 SM 的驻留资源和内部调度见 SM。
2.2 Thread Block Cluster
Compute Capability 9.0 及之后的 GPU 支持可选的 Thread Block Cluster。Cluster 不改变 Block 在 Grid 中的索引,而是把相邻 Block 同时调度到一个 GPC 内的一组 SM。
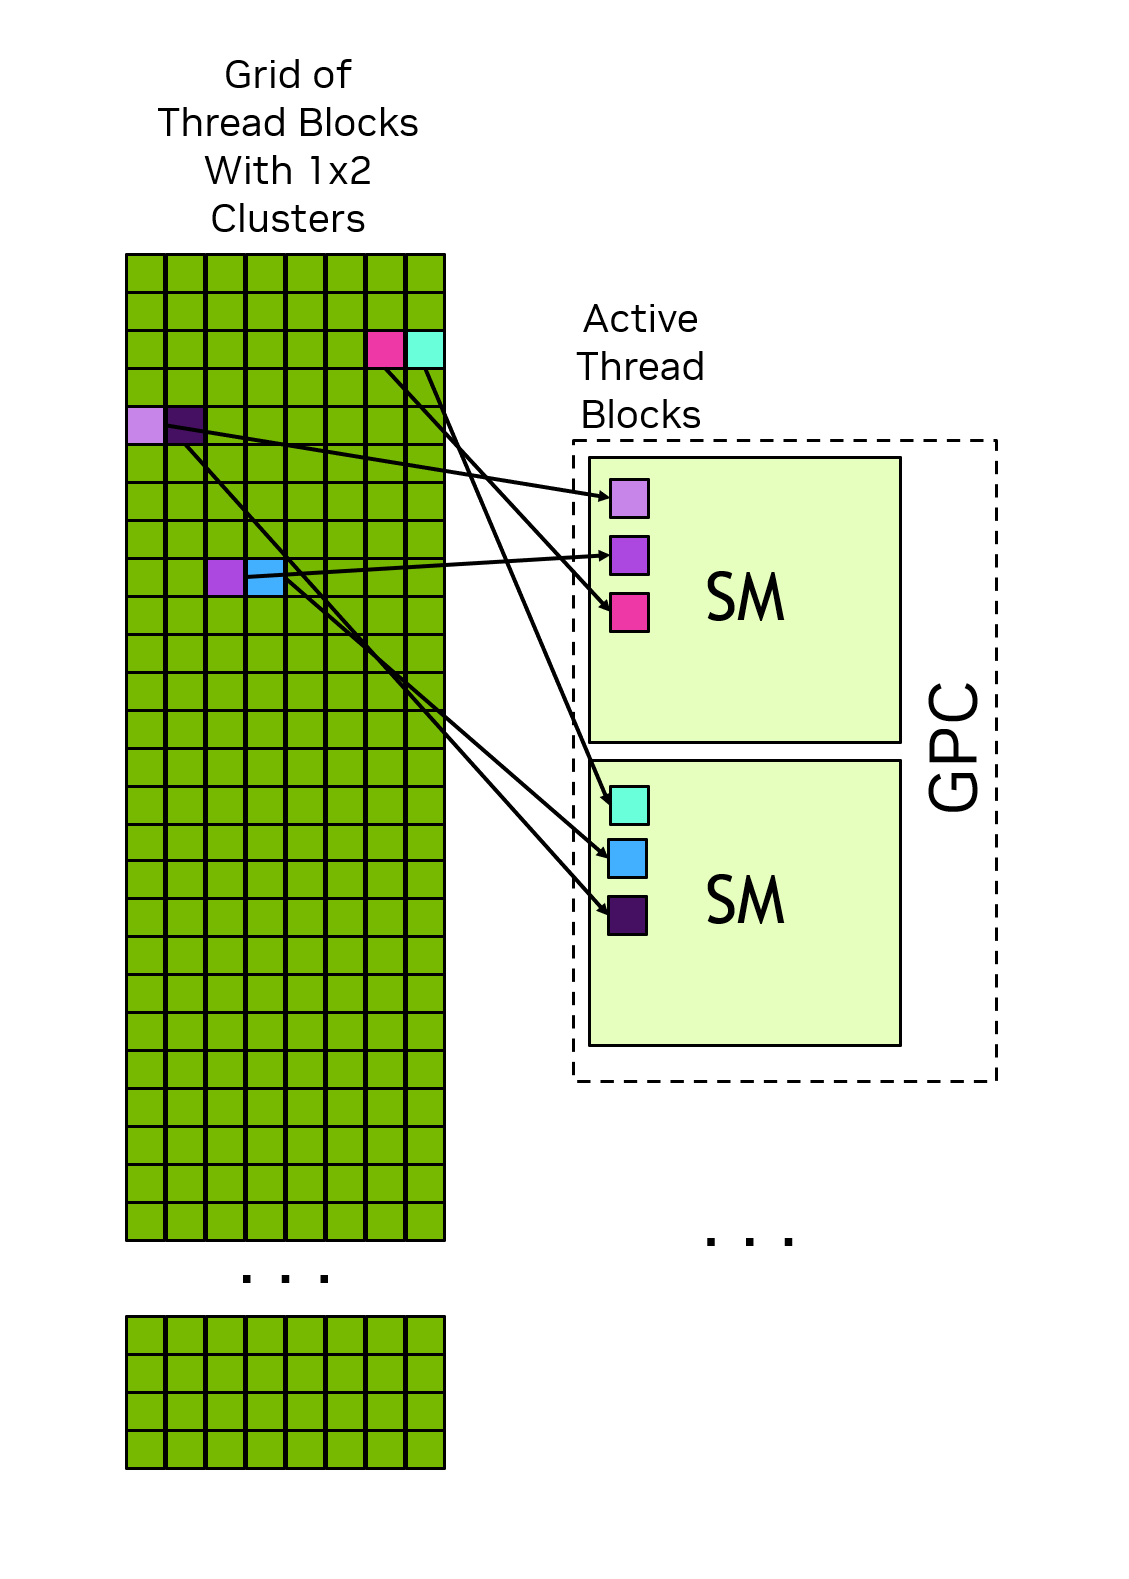
图 2:一个 Cluster 内的 Block 同时调度到同一 GPC。图源:NVIDIA CUDA Programming Guide。
Cluster 中的 Block 可以使用 Cooperative Groups 同步,并访问彼此的 Shared Memory,即 Distributed Shared Memory。Cluster 的最大形状由设备决定,使用前应查询目标 GPU 的能力。
3. SIMT 执行模型
SIMT(Single Instruction, Multiple Threads)让一个 Warp 中的线程共同执行一条指令,同时为每个线程保留独立的寄存器状态、地址和控制流。它与传统 SIMD 的主要区别在于:CUDA 程序按独立标量线程编写,Warp 宽度和 Lane 组合由硬件执行模型承担。
当 Warp 内所有线程沿相同路径执行时,32 个 Lane 可以同时参与当前指令。若数据相关分支让线程进入不同路径,硬件会分别执行各条路径,并屏蔽当前路径之外的线程:
if (threadIdx.x < 16) {
    // Warp 的一部分线程执行
} else {
    // 另一部分线程执行
}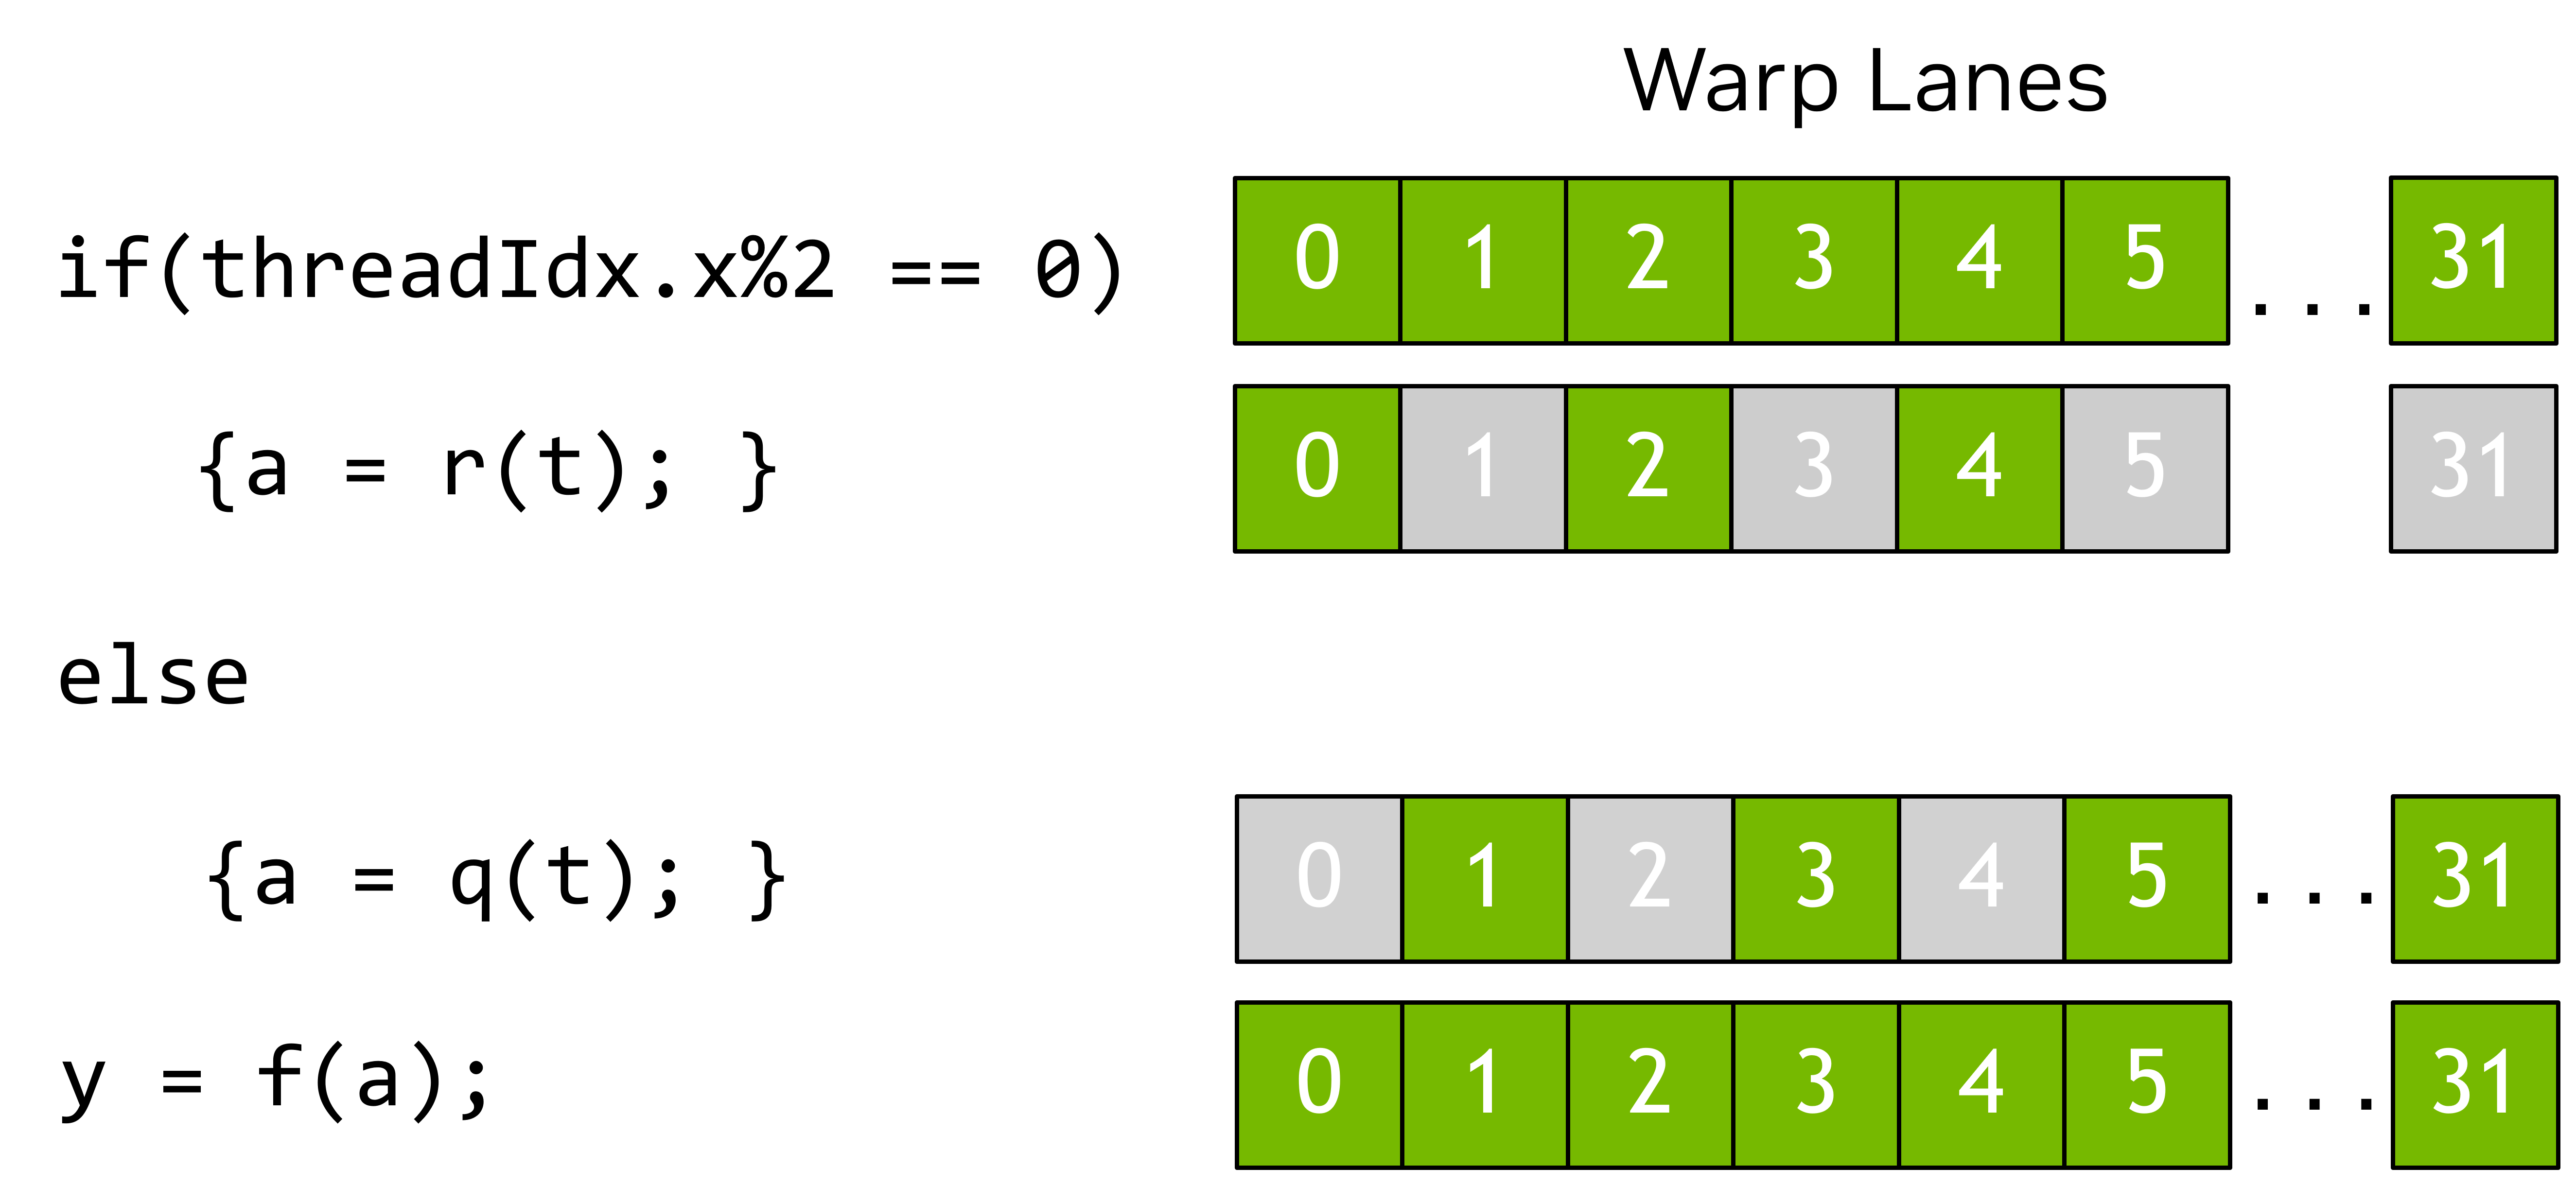
图 3:条件只对部分线程成立时,其他 Lane 在该路径执行期间被屏蔽。图源:NVIDIA CUDA Programming Guide。
这种 Warp Divergence 不会影响结果正确性,但会降低 Lane 利用率。分支是否昂贵取决于分支长度、各路径工作量以及编译器能否使用 Predication,不能只根据代码中是否出现 if 判断。
5. 同步范围
同步操作必须与数据共享范围匹配:
| 范围 | 常用机制 | 约束 |
|---|---|---|
| Warp | __syncwarp()、Warp Intrinsics | 只同步参与 Mask 的线程 |
| Thread Block | __syncthreads() | Block 内所有参与线程必须一致到达 Barrier |
| Grid | Kernel 边界或 Cooperative Groups | 普通 Kernel 内不存在默认的全 Grid Barrier |
| Host 与 Device | Stream/Event 同步、cudaDeviceSynchronize() | 同步粒度和并发能力取决于所用 API |
__syncthreads() 不只是执行屏障,也保证此前的 Shared Memory 和 Global Memory 访问对 Block 内线程可见。把它放进并非所有线程都会进入的条件分支,可能导致未定义行为或死锁。
6. 编译与指令层级
CUDA C++、PTX 和 SASS 分别处于高级语言、虚拟指令集和目标 GPU 机器指令三个层级:
CUDA C++ Device Code
  → PTX
  → ptxas
  → Cubin:目标 SM 的 SASS
→ Fatbin:一个或多个 Cubin / PTX 镜像- CUDA C++:使用
__global__、__device__和 Kernel Launch 语法描述并行程序。 - PTX:面向虚拟 Compute Architecture 的中间指令集,不是 GPU 直接执行的最终机器码。
- SASS:针对具体 SM Architecture 生成的机器指令,通常封装在 Cubin 中。
- Fatbin:可同时包含多个目标架构的 Cubin 和 PTX,Runtime 启动 Kernel 时选择兼容镜像;必要时 Driver 可将 PTX JIT 编译到当前 GPU。
以下命令分别保留 PTX、生成 Cubin,以及检查最终 SASS:
nvcc -arch=sm_90 --ptx kernel.cu -o kernel.ptx
nvcc -arch=sm_90 --cubin kernel.cu -o kernel.cubin
cuobjdump --dump-sass kernel.cubin
PTX 指令与 SASS 指令并非稳定的一一对应关系。编译器可以融合、消除或重排操作;判断 Kernel 实际使用了哪条硬件指令,应检查目标架构的 Cubin/SASS,而不能只看 CUDA C++ 源码或 PTX。
9. 参考
- NVIDIA CUDA Programming Guide:Programming Model
- NVIDIA CUDA Programming Guide:Writing SIMT Kernels
- NVIDIA CUDA Programming Guide:Writing Tile Kernels
- NVIDIA CUDA Programming Guide:Advanced Kernel Programming
- NVIDIA CUDA Programming Guide:NVCC
- NVIDIA CUDA Compiler Driver:Compilation Trajectory
- NVIDIA PTX ISA